mirror of
https://github.com/EDeev/declaude.git
synced 2026-10-08 04:59:30 +03:00
Compare commits
6 commits
b2d9deb4b4
...
6032c1a1a7
| Author | SHA1 | Date | |
|---|---|---|---|
|
6032c1a1a7 | ||
|
|
6064e7db46 | ||
|
|
2855096065 | ||
|
|
f5fa349815 | ||
|
|
676ca1e926 | ||
|
|
56bba831a9 |
29 changed files with 2562 additions and 2165 deletions
25
.github/workflows/ci.yml
vendored
Normal file
25
.github/workflows/ci.yml
vendored
Normal file
|
|
@ -0,0 +1,25 @@
|
||||||
|
name: CI
|
||||||
|
|
||||||
|
on:
|
||||||
|
push:
|
||||||
|
branches: [main]
|
||||||
|
pull_request:
|
||||||
|
|
||||||
|
jobs:
|
||||||
|
test:
|
||||||
|
runs-on: ubuntu-latest
|
||||||
|
strategy:
|
||||||
|
matrix:
|
||||||
|
python-version: ["3.9", "3.10", "3.11", "3.12", "3.13"]
|
||||||
|
steps:
|
||||||
|
- uses: actions/checkout@v4
|
||||||
|
- uses: actions/setup-python@v5
|
||||||
|
with:
|
||||||
|
python-version: ${{ matrix.python-version }}
|
||||||
|
- run: pip install -e . -r requirements-dev.txt
|
||||||
|
- name: Ruff
|
||||||
|
run: ruff check .
|
||||||
|
- name: Тесты
|
||||||
|
run: pytest -q
|
||||||
|
- name: Сборка пакета
|
||||||
|
run: python -m build
|
||||||
27
.github/workflows/release.yml
vendored
Normal file
27
.github/workflows/release.yml
vendored
Normal file
|
|
@ -0,0 +1,27 @@
|
||||||
|
name: Release
|
||||||
|
|
||||||
|
on:
|
||||||
|
push:
|
||||||
|
tags: ["v*"]
|
||||||
|
|
||||||
|
jobs:
|
||||||
|
pypi:
|
||||||
|
runs-on: ubuntu-latest
|
||||||
|
permissions:
|
||||||
|
contents: write
|
||||||
|
id-token: write
|
||||||
|
steps:
|
||||||
|
- uses: actions/checkout@v4
|
||||||
|
- uses: actions/setup-python@v5
|
||||||
|
with:
|
||||||
|
python-version: "3.12"
|
||||||
|
- run: pip install build
|
||||||
|
- run: python -m build
|
||||||
|
- name: Публикация на PyPI
|
||||||
|
uses: pypa/gh-action-pypi-publish@release/v1
|
||||||
|
with:
|
||||||
|
password: ${{ secrets.PYPI_API_TOKEN }}
|
||||||
|
- name: Пакет в релиз GitHub
|
||||||
|
env:
|
||||||
|
GH_TOKEN: ${{ github.token }}
|
||||||
|
run: gh release upload "$GITHUB_REF_NAME" dist/* --clobber || true
|
||||||
6
.gitignore
vendored
6
.gitignore
vendored
|
|
@ -2,3 +2,9 @@ __pycache__/
|
||||||
*.pyc
|
*.pyc
|
||||||
claude-backup-v1/
|
claude-backup-v1/
|
||||||
claude_archive/
|
claude_archive/
|
||||||
|
mapping.json
|
||||||
|
dist/
|
||||||
|
build/
|
||||||
|
*.egg-info/
|
||||||
|
.pytest_cache/
|
||||||
|
.ruff_cache/
|
||||||
|
|
|
||||||
107
README.en.md
Normal file
107
README.en.md
Normal file
|
|
@ -0,0 +1,107 @@
|
||||||
|
# declaude
|
||||||
|
|
||||||
|
[Русский](https://github.com/EDeev/declaude/blob/main/README.md) · **English**
|
||||||
|
|
||||||
|
[](https://github.com/EDeev/declaude/actions/workflows/ci.yml)
|
||||||
|
[](https://pypi.org/project/claude-export-html/)
|
||||||
|
[](https://pypi.org/project/claude-export-html/)
|
||||||
|
[](https://github.com/EDeev/declaude/blob/main/LICENSE)
|
||||||
|
|
||||||
|
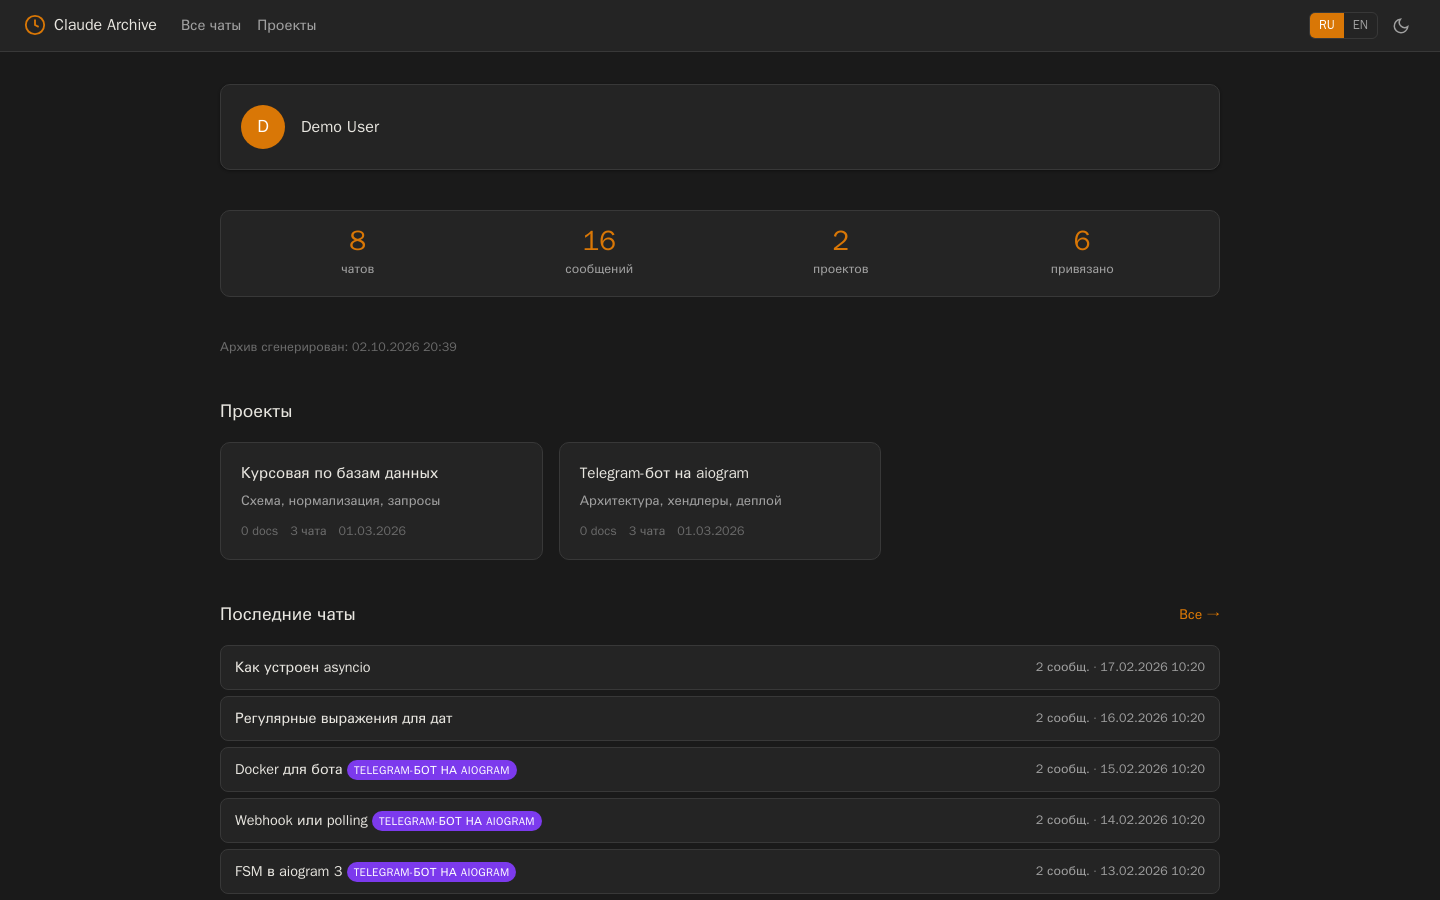
Turns a Claude.ai data export into a static HTML archive: browse, search and read all your chats and
|
||||||
|
projects in a browser, offline, with no servers or databases.
|
||||||
|
|
||||||
|
**Status:** personal project, maintained · online version at [fe0.ru/declaude](https://fe0.ru/declaude/)
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
**Stack:** Python 3.9+ (standard library only) · HTML · CSS · vanilla JS
|
||||||
|
|
||||||
|
## Features
|
||||||
|
|
||||||
|
- A page per chat and project, a home page with stats and recent chats
|
||||||
|
- Markdown: headings, lists, tables, quotes, code with highlighting (Python, JS/TS, SQL, Bash, Go, Rust)
|
||||||
|
- Search and filter across all chats, light and dark themes, Russian and English UI
|
||||||
|
- Assign chats to projects right in the browser and export `mapping.json`
|
||||||
|
- Incremental update from a new export: only changed chats are rebuilt
|
||||||
|
- Links from chats are safe: `javascript:` and similar schemes never reach the archive
|
||||||
|
|
||||||
|
## Installation
|
||||||
|
|
||||||
|
```bash
|
||||||
|
pipx install claude-export-html # or: pip install claude-export-html
|
||||||
|
```
|
||||||
|
|
||||||
|
Don't want to install anything? Upload the zip at [fe0.ru/declaude](https://fe0.ru/declaude/). If
|
||||||
|
privacy matters, run it locally.
|
||||||
|
|
||||||
|
## Usage
|
||||||
|
|
||||||
|
1. Claude.ai → **Settings → Privacy → Export data**, download the zip from the email and unpack it.
|
||||||
|
2. Build the archive and open `claude_archive/index.html`:
|
||||||
|
|
||||||
|
```bash
|
||||||
|
declaude --build --source ./claude-export
|
||||||
|
declaude --build --source ./claude-export --output ./my-archive # custom folder
|
||||||
|
declaude --update new_export.zip # add a newer export
|
||||||
|
declaude --map <conversation_uuid> <project_uuid> && declaude --remap
|
||||||
|
```
|
||||||
|
|
||||||
|
| Option | Purpose |
|
||||||
|
|---|---|
|
||||||
|
| `--build` | full build from an unpacked export |
|
||||||
|
| `--source PATH` | export folder (default `claude-backup-v1`) |
|
||||||
|
| `--output PATH` | archive folder (default `claude_archive`) |
|
||||||
|
| `--update ZIP` | add data from a new zip, project assignments are kept |
|
||||||
|
| `--map CHAT PROJECT`, `--remap` | assign a chat to a project and rebuild the home and project pages |
|
||||||
|
| `--mapping PATH` | assignments file (default `./mapping.json`) |
|
||||||
|
|
||||||
|
`python -m declaude` works as well as the `declaude` command.
|
||||||
|
|
||||||
|
> [!NOTE]
|
||||||
|
> The archive is plain HTML files; no data is sent anywhere. Theme and language choices are stored in
|
||||||
|
> the browser's localStorage.
|
||||||
|
|
||||||
|
## Screenshots
|
||||||
|
|
||||||
|
| Chat | Project |
|
||||||
|
|---|---|
|
||||||
|
| 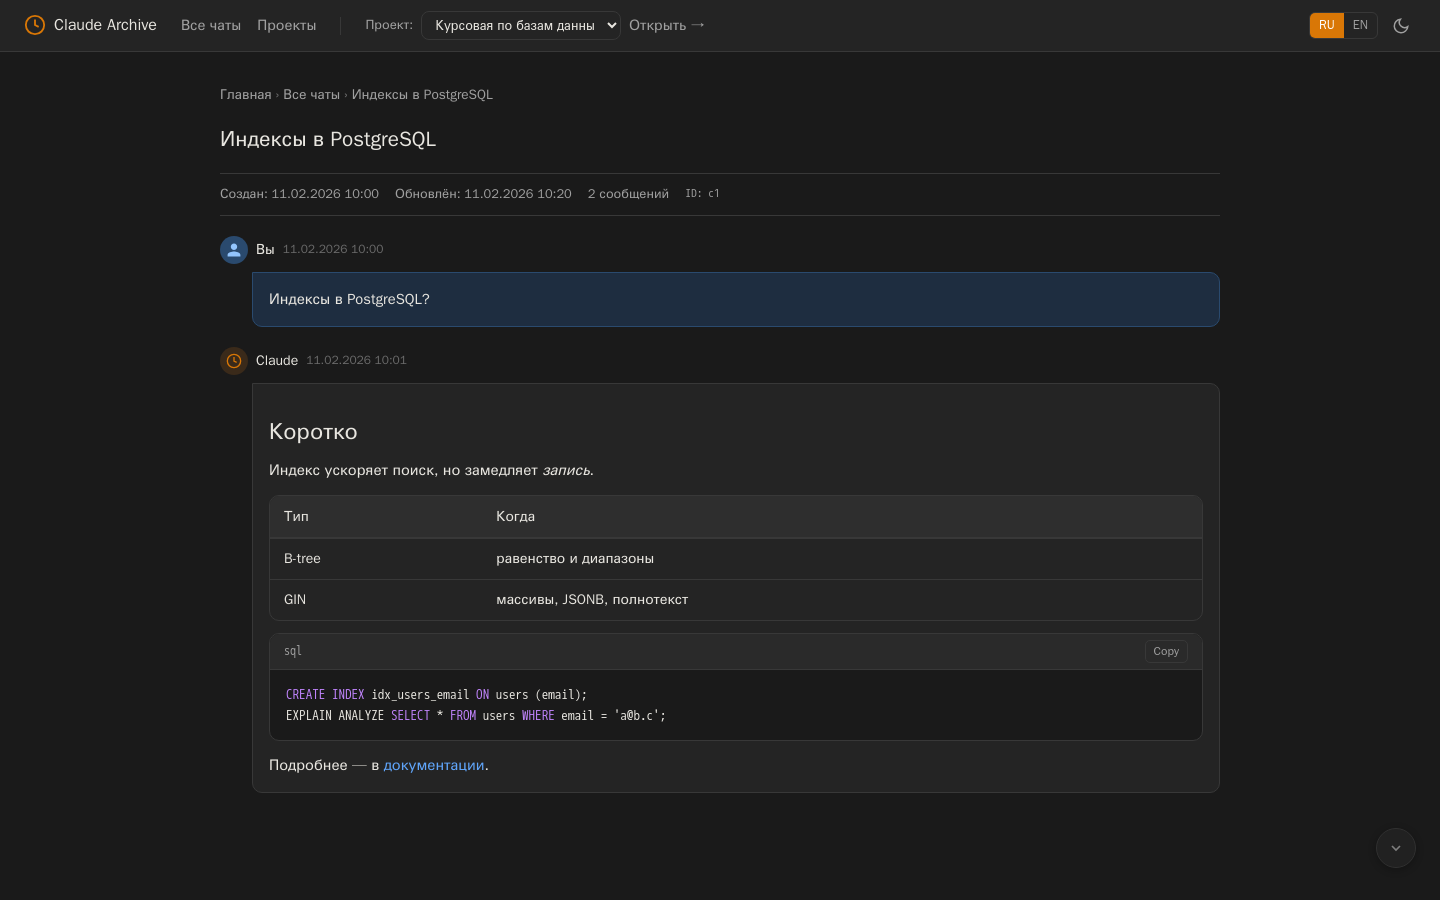 | 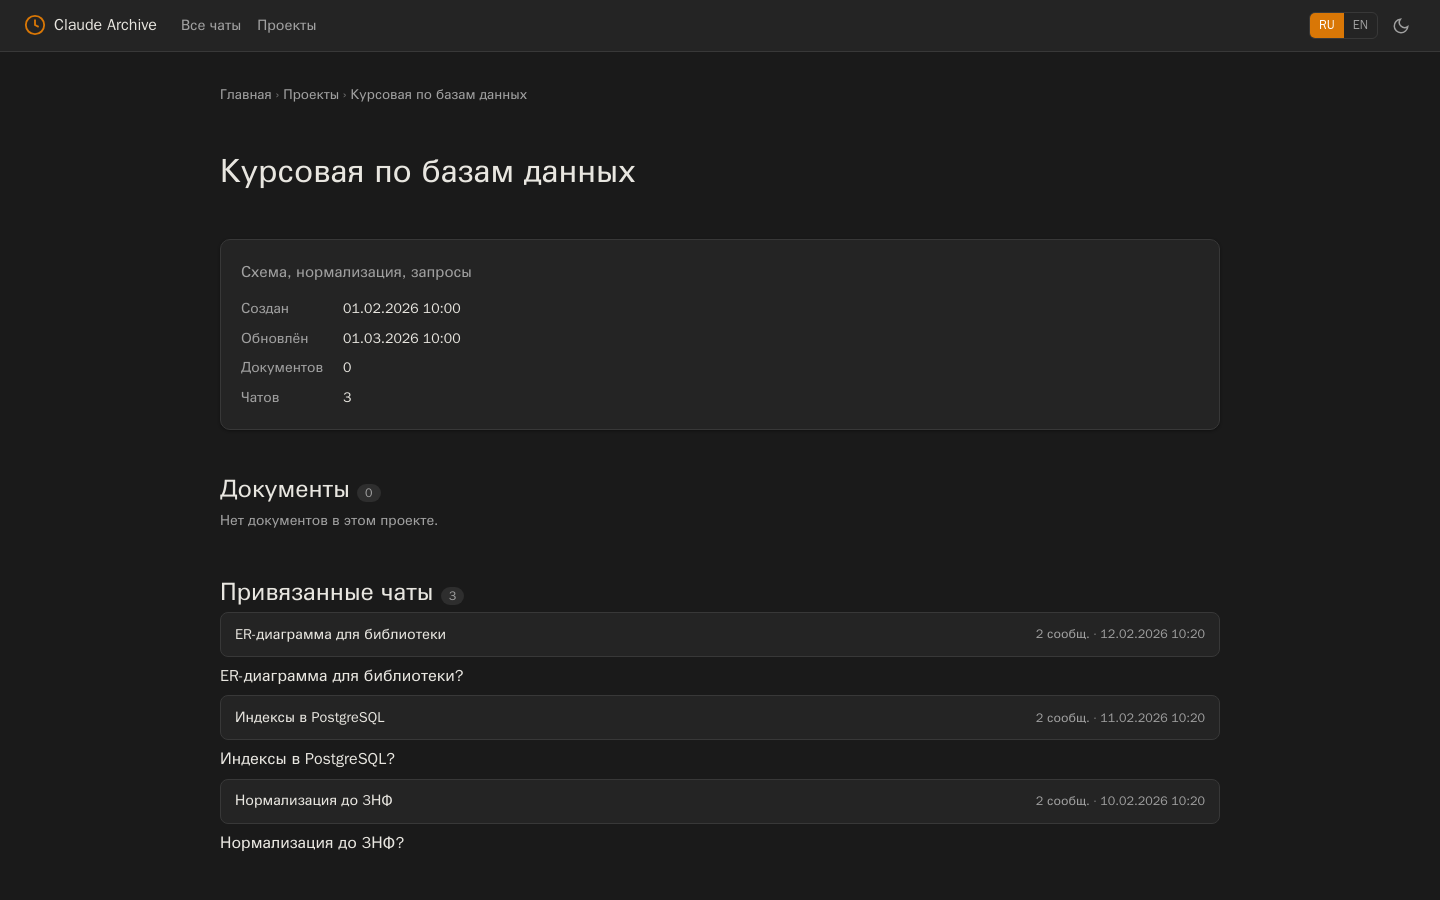 |
|
||||||
|
|
||||||
|
## Using from Python
|
||||||
|
|
||||||
|
```python
|
||||||
|
from pathlib import Path
|
||||||
|
from declaude import DataLoader, MappingManager, SiteBuilder
|
||||||
|
|
||||||
|
loader = DataLoader(Path("claude-export")); loader.load()
|
||||||
|
mapping = MappingManager(Path("mapping.json")); mapping.load()
|
||||||
|
SiteBuilder(Path("archive"), loader, mapping).build_all()
|
||||||
|
```
|
||||||
|
|
||||||
|
This is how the web version on fe0.ru uses it; FastAPI integration notes (in Russian):
|
||||||
|
[docs/fastapi-integration.md](https://github.com/EDeev/declaude/blob/main/docs/fastapi-integration.md).
|
||||||
|
|
||||||
|
## Development
|
||||||
|
|
||||||
|
```bash
|
||||||
|
pip install -e . -r requirements-dev.txt
|
||||||
|
ruff check . && pytest
|
||||||
|
```
|
||||||
|
|
||||||
|
The tests build an archive from a fictional export in `tests/fixtures` and check pages, Markdown,
|
||||||
|
escaping and link safety. CI runs them on Python 3.9–3.13; every `v*` tag publishes the package to PyPI.
|
||||||
|
|
||||||
|
## License
|
||||||
|
|
||||||
|
MIT — see [LICENSE](https://github.com/EDeev/declaude/blob/main/LICENSE).
|
||||||
|
|
||||||
|
## Author
|
||||||
|
|
||||||
|
**Egor Deev** — [GitHub](https://github.com/EDeev) · [Telegram](https://t.me/DeevEgor) · [egor@deev.space](mailto:egor@deev.space)
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
<div align="center">
|
||||||
|
<sub>⭐ If you find this project useful, give it a star on GitHub!</sub>
|
||||||
|
<p><sub>Made with ❤️ — <a href="https://deev.space">deev.space</a></sub></p>
|
||||||
|
</div>
|
||||||
149
README.md
149
README.md
|
|
@ -1,91 +1,108 @@
|
||||||
# declaude
|
# declaude
|
||||||
|
|
||||||
Автономная утилита для преобразования официального экспорта данных Claude.ai в интерактивный статический HTML-архив.
|
**Русский** · [English](README.en.md)
|
||||||
|
|
||||||
Позволяет локально хранить, просматривать и быстро искать диалоги без внешних зависимостей и необходимости поднимать базы данных или веб-серверы.
|
[](https://github.com/EDeev/declaude/actions/workflows/ci.yml)
|
||||||
|
[](https://pypi.org/project/claude-export-html/)
|
||||||
|
[](https://pypi.org/project/claude-export-html/)
|
||||||
|
[](LICENSE)
|
||||||
|
|
||||||
## Онлайн-версия
|
Превращает экспорт данных Claude.ai в статический HTML-архив: все чаты и проекты можно листать,
|
||||||
|
искать и читать в браузере без интернета, серверов и баз данных.
|
||||||
|
|
||||||
Не хочется устанавливать Python и разбираться руками — есть готовая веб-версия:
|
**Статус:** личный проект, работает · онлайн-версия на [fe0.ru/declaude](https://fe0.ru/declaude/)
|
||||||
**https://fe0.ru/declaude/**. Загружаете zip-экспорт, получаете готовый архив — без установки
|
|
||||||
чего-либо. Если важна приватность данных, запустите скрипт локально по инструкции ниже.
|

|
||||||
|
|
||||||
|
**Стек:** Python 3.9+ (только стандартная библиотека) · HTML · CSS · vanilla JS
|
||||||
|
|
||||||
## Возможности
|
## Возможности
|
||||||
|
|
||||||
- **Полная автономность:** генерирует чистые HTML-страницы для каждого диалога, которые открываются в любом браузере.
|
- Отдельная страница на каждый чат и проект, главная со статистикой и последними чатами
|
||||||
- **Страницы проектов:** рендеринг контекстных документов и шаблонов системных промптов для каждого проекта.
|
- Markdown: заголовки, списки, таблицы, цитаты, код с подсветкой (Python, JS/TS, SQL, Bash, Go, Rust)
|
||||||
- **Полноценная поддержка Markdown:** заголовки, списки, таблицы, цитаты, блоки кода.
|
- Поиск и фильтр по всем чатам, светлая и тёмная тема, интерфейс на русском и английском
|
||||||
- **Подсветка синтаксиса без сторонних библиотек:** встроенная поддержка Python, JavaScript, TypeScript, SQL, Bash, Go и Rust.
|
- Привязка чатов к проектам прямо в браузере с выгрузкой `mapping.json`
|
||||||
- **Темы оформления и языки:** переключение между светлой и тёмной темой, а также интерфейс на русском и английском языках (выбор сохраняется в LocalStorage).
|
- Инкрементальное обновление из нового экспорта: пересобираются только изменённые чаты
|
||||||
- **Маппинг проектов:** возможность связывать диалоги с проектами прямо в браузере с выгрузкой файла `mapping.json` и быстрой пересборкой.
|
- Ссылки из чатов безопасны: `javascript:` и подобные схемы не попадают в архив
|
||||||
- **Инкрементальные обновления:** режим `--update` обновляет только добавленные или изменённые диалоги.
|
|
||||||
- **Нулевые зависимости:** работает исключительно на стандартной библиотеке Python 3.8+.
|
|
||||||
|
|
||||||
## Подготовка данных
|
## Установка
|
||||||
|
|
||||||
1. Откройте **claude.ai → Settings → Privacy → Export data**.
|
```bash
|
||||||
2. Дождитесь письма со ссылкой и скачайте zip-архив с выгрузкой.
|
pipx install claude-export-html # или: pip install claude-export-html
|
||||||
3. Распакуйте архив в отдельную папку. Внутри находятся файлы `conversations.json`, `users.json` и каталог `projects/`.
|
```
|
||||||
|
|
||||||
|
Не хочется ничего ставить — загрузите zip на [fe0.ru/declaude](https://fe0.ru/declaude/). Если важна
|
||||||
|
приватность, запускайте локально.
|
||||||
|
|
||||||
## Использование
|
## Использование
|
||||||
|
|
||||||
### Первая сборка архива
|
1. Claude.ai → **Settings → Privacy → Export data**, скачайте zip из письма и распакуйте.
|
||||||
|
2. Соберите архив и откройте `claude_archive/index.html`:
|
||||||
|
|
||||||
```bash
|
```bash
|
||||||
python declaude.py --build --source ./claude-export
|
declaude --build --source ./claude-export
|
||||||
|
declaude --build --source ./claude-export --output ./my-archive # своя папка
|
||||||
|
declaude --update new_export.zip # добавить новый экспорт
|
||||||
|
declaude --map <conversation_uuid> <project_uuid> && declaude --remap
|
||||||
```
|
```
|
||||||
|
|
||||||
После завершения откройте файл `claude_archive/index.html` в браузере.
|
| Параметр | Назначение |
|
||||||
|
|---|---|
|
||||||
|
| `--build` | полная сборка из распакованного экспорта |
|
||||||
|
| `--source ПУТЬ` | папка с экспортом (по умолчанию `claude-backup-v1`) |
|
||||||
|
| `--output ПУТЬ` | куда сложить архив (по умолчанию `claude_archive`) |
|
||||||
|
| `--update ZIP` | добавить данные из нового zip, привязки к проектам сохраняются |
|
||||||
|
| `--map ЧАТ ПРОЕКТ`, `--remap` | привязать чат к проекту и пересобрать главную и проекты |
|
||||||
|
| `--mapping ПУТЬ` | файл привязок (по умолчанию `./mapping.json`) |
|
||||||
|
|
||||||
### Указание своей папки для архива
|
Вместо команды `declaude` можно запускать `python -m declaude`.
|
||||||
|
|
||||||
|
> [!NOTE]
|
||||||
|
> Архив — обычные HTML-файлы, данные никуда не отправляются. Выбор темы и языка хранится в
|
||||||
|
> localStorage браузера.
|
||||||
|
|
||||||
|
## Как выглядит
|
||||||
|
|
||||||
|
| Чат | Проект |
|
||||||
|
|---|---|
|
||||||
|
|  |  |
|
||||||
|
|
||||||
|
## Использование из Python
|
||||||
|
|
||||||
|
```python
|
||||||
|
from pathlib import Path
|
||||||
|
from declaude import DataLoader, MappingManager, SiteBuilder
|
||||||
|
|
||||||
|
loader = DataLoader(Path("claude-export")); loader.load()
|
||||||
|
mapping = MappingManager(Path("mapping.json")); mapping.load()
|
||||||
|
SiteBuilder(Path("archive"), loader, mapping).build_all()
|
||||||
|
```
|
||||||
|
|
||||||
|
Так библиотека встроена в веб-версию на fe0.ru — заметки об интеграции в FastAPI:
|
||||||
|
[docs/fastapi-integration.md](docs/fastapi-integration.md).
|
||||||
|
|
||||||
|
## Разработка
|
||||||
|
|
||||||
```bash
|
```bash
|
||||||
python declaude.py --build --source ./claude-export --output ./my-archive
|
pip install -e . -r requirements-dev.txt
|
||||||
|
ruff check . && pytest
|
||||||
```
|
```
|
||||||
|
|
||||||
### Инкрементальное обновление из нового архива
|
Тесты собирают архив из вымышленного экспорта в `tests/fixtures` и проверяют страницы, Markdown,
|
||||||
|
экранирование и защиту ссылок. CI гоняет их на Python 3.9–3.13; на каждый тег `v*` пакет публикуется
|
||||||
```bash
|
на PyPI.
|
||||||
python declaude.py --update new_export.zip
|
|
||||||
```
|
|
||||||
|
|
||||||
Регенерируются только новые и отредактированные страницы, текущая привязка диалогов к проектам в `mapping.json` сохраняется.
|
|
||||||
|
|
||||||
### Назначение диалога проекту через консоль
|
|
||||||
|
|
||||||
```bash
|
|
||||||
python declaude.py --map <conversation_uuid> <project_uuid>
|
|
||||||
python declaude.py --remap
|
|
||||||
```
|
|
||||||
|
|
||||||
Быстрая пересборка страниц проектов (`--remap`) занимает секунды, так как не пересобирает неизменённые диалоги.
|
|
||||||
|
|
||||||
## Структура сгенерированного архива
|
|
||||||
|
|
||||||
```
|
|
||||||
claude_archive/
|
|
||||||
├── index.html # Главная страница: статистика, проекты, последние чаты
|
|
||||||
├── all_conversations.html # Полный список диалогов с поиском и фильтрацией
|
|
||||||
├── conversations/
|
|
||||||
│ └── <uuid>.html # Страницы отдельных диалогов
|
|
||||||
├── projects/
|
|
||||||
│ └── <uuid>/
|
|
||||||
│ └── index.html # Страницы проектов с документами и диалогами
|
|
||||||
└── assets/
|
|
||||||
├── style.css
|
|
||||||
└── app.js
|
|
||||||
```
|
|
||||||
|
|
||||||
## Параметры командной строки
|
|
||||||
|
|
||||||
- `--build` — полная сборка архива из исходного каталога.
|
|
||||||
- `--source ПУТЬ` — путь к каталогу с распакованным экспортом (по умолчанию: `claude-backup-v1`).
|
|
||||||
- `--output ПУТЬ` — каталог для сохранения HTML-архива (по умолчанию: `claude_archive`).
|
|
||||||
- `--update АРХИВ.ZIP` — добавление данных из нового zip-архива с сохранением маппинга.
|
|
||||||
- `--remap` — быстрая пересборка индексной страницы и страниц проектов.
|
|
||||||
- `--map CONV_ID PROJ_ID` — ручное сопоставление диалога с проектом.
|
|
||||||
- `--mapping ПУТЬ` — путь к файлу сопоставлений (по умолчанию: `./mapping.json`).
|
|
||||||
|
|
||||||
## Лицензия
|
## Лицензия
|
||||||
|
|
||||||
MIT
|
MIT — см. [LICENSE](LICENSE).
|
||||||
|
|
||||||
|
## Автор
|
||||||
|
|
||||||
|
**Деев Егор Викторович** — [GitHub](https://github.com/EDeev) · [Telegram](https://t.me/DeevEgor) · [egor@deev.space](mailto:egor@deev.space)
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
<div align="center">
|
||||||
|
<sub>⭐ Если проект оказался полезным, поставьте звёздочку на GitHub!</sub>
|
||||||
|
<p><sub>Сделано с ❤️ — <a href="https://deev.space">deev.space</a></sub></p>
|
||||||
|
</div>
|
||||||
|
|
|
||||||
2098
declaude.py
2098
declaude.py
File diff suppressed because it is too large
Load diff
9
declaude/__init__.py
Normal file
9
declaude/__init__.py
Normal file
|
|
@ -0,0 +1,9 @@
|
||||||
|
"""declaude — converts a Claude.ai data export into a static HTML archive."""
|
||||||
|
|
||||||
|
from .html import HtmlBuilder
|
||||||
|
from .loader import DataLoader, MappingManager, extract_zip
|
||||||
|
from .markdown import MarkdownRenderer
|
||||||
|
from .site import SiteBuilder
|
||||||
|
|
||||||
|
__version__ = "1.0.0"
|
||||||
|
__all__ = ["DataLoader", "HtmlBuilder", "MappingManager", "MarkdownRenderer", "SiteBuilder", "extract_zip"]
|
||||||
3
declaude/__main__.py
Normal file
3
declaude/__main__.py
Normal file
|
|
@ -0,0 +1,3 @@
|
||||||
|
from .cli import main
|
||||||
|
|
||||||
|
main()
|
||||||
237
declaude/assets/app.js
Normal file
237
declaude/assets/app.js
Normal file
|
|
@ -0,0 +1,237 @@
|
||||||
|
|
||||||
|
// ===== Theme =====
|
||||||
|
(function() {
|
||||||
|
var saved = localStorage.getItem('claude-theme') || 'dark';
|
||||||
|
document.documentElement.setAttribute('data-theme', saved);
|
||||||
|
updateThemeIcons(saved);
|
||||||
|
})();
|
||||||
|
|
||||||
|
function toggleTheme() {
|
||||||
|
var current = document.documentElement.getAttribute('data-theme');
|
||||||
|
var next = current === 'dark' ? 'light' : 'dark';
|
||||||
|
document.documentElement.setAttribute('data-theme', next);
|
||||||
|
localStorage.setItem('claude-theme', next);
|
||||||
|
updateThemeIcons(next);
|
||||||
|
}
|
||||||
|
|
||||||
|
function updateThemeIcons(theme) {
|
||||||
|
var moon = document.querySelector('.icon-moon');
|
||||||
|
var sun = document.querySelector('.icon-sun');
|
||||||
|
if (!moon || !sun) return;
|
||||||
|
if (theme === 'dark') { moon.style.display = ''; sun.style.display = 'none'; }
|
||||||
|
else { moon.style.display = 'none'; sun.style.display = ''; }
|
||||||
|
}
|
||||||
|
|
||||||
|
// ===== Language (i18n) =====
|
||||||
|
(function() {
|
||||||
|
var saved = localStorage.getItem('claude-lang') || 'ru';
|
||||||
|
applyLang(saved, false);
|
||||||
|
})();
|
||||||
|
|
||||||
|
function setLang(lang) {
|
||||||
|
localStorage.setItem('claude-lang', lang);
|
||||||
|
applyLang(lang, true);
|
||||||
|
}
|
||||||
|
|
||||||
|
function applyLang(lang, animate) {
|
||||||
|
// Show/hide inline spans
|
||||||
|
document.querySelectorAll('[data-lang]').forEach(function(el) {
|
||||||
|
if (el.getAttribute('data-lang') === lang) {
|
||||||
|
el.classList.add('lang-visible');
|
||||||
|
} else {
|
||||||
|
el.classList.remove('lang-visible');
|
||||||
|
}
|
||||||
|
});
|
||||||
|
// Show/hide block elements
|
||||||
|
document.querySelectorAll('[data-lang-block]').forEach(function(el) {
|
||||||
|
if (el.getAttribute('data-lang-block') === lang) {
|
||||||
|
el.classList.add('lang-visible');
|
||||||
|
} else {
|
||||||
|
el.classList.remove('lang-visible');
|
||||||
|
}
|
||||||
|
});
|
||||||
|
// Translate option elements that have data-ru / data-en attributes
|
||||||
|
document.querySelectorAll('option[data-ru]').forEach(function(el) {
|
||||||
|
var t = el.getAttribute('data-' + lang);
|
||||||
|
if (t) el.textContent = t;
|
||||||
|
});
|
||||||
|
// Translate search input placeholder
|
||||||
|
document.querySelectorAll('input[data-placeholder-ru]').forEach(function(el) {
|
||||||
|
var t = el.getAttribute('data-placeholder-' + lang);
|
||||||
|
if (t) el.placeholder = t;
|
||||||
|
});
|
||||||
|
// Toggle button states
|
||||||
|
var btnRu = document.getElementById('langRu');
|
||||||
|
var btnEn = document.getElementById('langEn');
|
||||||
|
if (btnRu) btnRu.classList.toggle('active', lang === 'ru');
|
||||||
|
if (btnEn) btnEn.classList.toggle('active', lang === 'en');
|
||||||
|
// Update sync status text if on index
|
||||||
|
updateSyncStatus();
|
||||||
|
// Update filter count label
|
||||||
|
var label = document.getElementById('countLabel');
|
||||||
|
if (label && label.textContent) filterConvs();
|
||||||
|
}
|
||||||
|
|
||||||
|
// ===== Copy code =====
|
||||||
|
function copyCode(btn) {
|
||||||
|
var pre = btn.closest('.code-block').querySelector('pre');
|
||||||
|
var text = pre ? pre.innerText : '';
|
||||||
|
navigator.clipboard.writeText(text).then(function() {
|
||||||
|
btn.textContent = 'Copied!';
|
||||||
|
btn.classList.add('copied');
|
||||||
|
setTimeout(function() { btn.textContent = 'Copy'; btn.classList.remove('copied'); }, 1500);
|
||||||
|
}).catch(function() {
|
||||||
|
btn.textContent = 'Error';
|
||||||
|
setTimeout(function() { btn.textContent = 'Copy'; }, 1500);
|
||||||
|
});
|
||||||
|
}
|
||||||
|
|
||||||
|
// ===== Scroll FABs =====
|
||||||
|
function scrollToTop() {
|
||||||
|
window.scrollTo({ top: 0, behavior: 'smooth' });
|
||||||
|
}
|
||||||
|
|
||||||
|
function scrollToBottom() {
|
||||||
|
window.scrollTo({ top: document.body.scrollHeight, behavior: 'smooth' });
|
||||||
|
}
|
||||||
|
|
||||||
|
function updateScrollFabs() {
|
||||||
|
var fabTop = document.getElementById('fabTop');
|
||||||
|
var fabBottom = document.getElementById('fabBottom');
|
||||||
|
if (!fabTop || !fabBottom) return;
|
||||||
|
var scrolled = window.scrollY;
|
||||||
|
var maxScroll = document.body.scrollHeight - window.innerHeight;
|
||||||
|
// Show "top" button after scrolling down 200px
|
||||||
|
fabTop.classList.toggle('hidden', scrolled < 200);
|
||||||
|
// Hide "bottom" button when within 100px of the bottom
|
||||||
|
fabBottom.classList.toggle('hidden', maxScroll > 0 && scrolled >= maxScroll - 100);
|
||||||
|
}
|
||||||
|
|
||||||
|
// ===== Mapping (localStorage) =====
|
||||||
|
var MAPPING_KEY = 'claude-mapping';
|
||||||
|
|
||||||
|
function loadBrowserMapping() {
|
||||||
|
try { return JSON.parse(localStorage.getItem(MAPPING_KEY) || '{}'); }
|
||||||
|
catch(e) { return {}; }
|
||||||
|
}
|
||||||
|
|
||||||
|
function saveBrowserMapping(m) {
|
||||||
|
localStorage.setItem(MAPPING_KEY, JSON.stringify(m));
|
||||||
|
}
|
||||||
|
|
||||||
|
function assignProject(convUuid, projUuid) {
|
||||||
|
var m = loadBrowserMapping();
|
||||||
|
if (projUuid) {
|
||||||
|
m[convUuid] = projUuid;
|
||||||
|
} else {
|
||||||
|
delete m[convUuid];
|
||||||
|
}
|
||||||
|
saveBrowserMapping(m);
|
||||||
|
// Update the "Open project" link in topbar
|
||||||
|
var link = document.getElementById('assignProjLink');
|
||||||
|
if (link) {
|
||||||
|
if (projUuid) {
|
||||||
|
link.href = '../projects/' + projUuid + '/index.html';
|
||||||
|
link.style.display = '';
|
||||||
|
} else {
|
||||||
|
link.style.display = 'none';
|
||||||
|
}
|
||||||
|
}
|
||||||
|
}
|
||||||
|
|
||||||
|
function exportMapping() {
|
||||||
|
var m = loadBrowserMapping();
|
||||||
|
var json = JSON.stringify(m, null, 2);
|
||||||
|
var blob = new Blob([json], { type: 'application/json' });
|
||||||
|
var a = document.createElement('a');
|
||||||
|
a.href = URL.createObjectURL(blob);
|
||||||
|
a.download = 'mapping.json';
|
||||||
|
a.click();
|
||||||
|
URL.revokeObjectURL(a.href);
|
||||||
|
}
|
||||||
|
|
||||||
|
function clearBrowserMapping() {
|
||||||
|
var lang = localStorage.getItem('claude-lang') || 'ru';
|
||||||
|
var msg = lang === 'en'
|
||||||
|
? 'Reset all browser mapping? (mapping.json on disk will not change)'
|
||||||
|
: 'Сбросить весь браузерный маппинг? (mapping.json на диске не изменится)';
|
||||||
|
if (confirm(msg)) {
|
||||||
|
localStorage.removeItem(MAPPING_KEY);
|
||||||
|
updateSyncStatus();
|
||||||
|
}
|
||||||
|
}
|
||||||
|
|
||||||
|
function updateSyncStatus() {
|
||||||
|
var el = document.getElementById('syncStatus');
|
||||||
|
if (!el) return;
|
||||||
|
var m = loadBrowserMapping();
|
||||||
|
var cnt = Object.keys(m).length;
|
||||||
|
var lang = localStorage.getItem('claude-lang') || 'ru';
|
||||||
|
if (lang === 'en') {
|
||||||
|
el.textContent = cnt > 0 ? cnt + ' mappings in browser (not saved)' : 'No unsaved mappings';
|
||||||
|
} else {
|
||||||
|
el.textContent = cnt > 0 ? cnt + ' привязок в браузере (не сохранено)' : 'Нет несохранённых привязок';
|
||||||
|
}
|
||||||
|
}
|
||||||
|
|
||||||
|
// ===== Filter & search (all_conversations page) =====
|
||||||
|
function filterConvs() {
|
||||||
|
var q = (document.getElementById('searchInput') || { value: '' }).value.toLowerCase();
|
||||||
|
var proj = (document.getElementById('projFilter') || { value: '' }).value;
|
||||||
|
var sort = (document.getElementById('sortSelect') || { value: 'updated' }).value;
|
||||||
|
|
||||||
|
var cards = Array.from(document.querySelectorAll('.conv-card'));
|
||||||
|
var visible = [];
|
||||||
|
|
||||||
|
cards.forEach(function(card) {
|
||||||
|
var name = (card.dataset.name || '');
|
||||||
|
var preview = (card.dataset.preview || '');
|
||||||
|
var cardProj = (card.dataset.proj || '');
|
||||||
|
var matchQ = !q || name.includes(q) || preview.includes(q);
|
||||||
|
var matchP = !proj || (proj === '__none__' ? !cardProj : cardProj === proj);
|
||||||
|
var show = matchQ && matchP;
|
||||||
|
card.style.display = show ? '' : 'none';
|
||||||
|
if (show) visible.push(card);
|
||||||
|
});
|
||||||
|
|
||||||
|
// Sort
|
||||||
|
var grid = document.getElementById('convGrid');
|
||||||
|
if (grid) {
|
||||||
|
visible.sort(function(a, b) {
|
||||||
|
if (sort === 'msgs') return parseInt(b.dataset.msgs || 0) - parseInt(a.dataset.msgs || 0);
|
||||||
|
if (sort === 'created') return (b.dataset.created || '').localeCompare(a.dataset.created || '');
|
||||||
|
return (b.dataset.updated || '').localeCompare(a.dataset.updated || '');
|
||||||
|
});
|
||||||
|
visible.forEach(function(c) { grid.appendChild(c); });
|
||||||
|
}
|
||||||
|
|
||||||
|
var lang = localStorage.getItem('claude-lang') || 'ru';
|
||||||
|
var label = document.getElementById('countLabel');
|
||||||
|
if (label) {
|
||||||
|
label.textContent = lang === 'en'
|
||||||
|
? visible.length + ' of ' + cards.length
|
||||||
|
: visible.length + ' из ' + cards.length;
|
||||||
|
}
|
||||||
|
}
|
||||||
|
|
||||||
|
// ===== Init =====
|
||||||
|
document.addEventListener('DOMContentLoaded', function() {
|
||||||
|
// Re-apply theme icons (DOM now ready)
|
||||||
|
var savedTheme = localStorage.getItem('claude-theme') || 'dark';
|
||||||
|
updateThemeIcons(savedTheme);
|
||||||
|
|
||||||
|
// Apply language
|
||||||
|
var savedLang = localStorage.getItem('claude-lang') || 'ru';
|
||||||
|
applyLang(savedLang, false);
|
||||||
|
|
||||||
|
if (window.PAGE_TYPE === 'all_convs') {
|
||||||
|
filterConvs();
|
||||||
|
}
|
||||||
|
if (document.getElementById('syncPanel')) {
|
||||||
|
updateSyncStatus();
|
||||||
|
}
|
||||||
|
if (window.PAGE_TYPE === 'conversation') {
|
||||||
|
window.addEventListener('scroll', updateScrollFabs, { passive: true });
|
||||||
|
updateScrollFabs();
|
||||||
|
}
|
||||||
|
});
|
||||||
481
declaude/assets/style.css
Normal file
481
declaude/assets/style.css
Normal file
|
|
@ -0,0 +1,481 @@
|
||||||
|
|
||||||
|
/* ===== Reset & base ===== */
|
||||||
|
*, *::before, *::after { box-sizing: border-box; margin: 0; padding: 0; }
|
||||||
|
|
||||||
|
:root {
|
||||||
|
--bg: #1a1a1a;
|
||||||
|
--bg2: #242424;
|
||||||
|
--bg3: #2e2e2e;
|
||||||
|
--border: #383838;
|
||||||
|
--text: #e8e6e0;
|
||||||
|
--text2: #a0a0a0;
|
||||||
|
--text3: #6b6b6b;
|
||||||
|
--accent: #d97706;
|
||||||
|
--accent-hover: #b45309;
|
||||||
|
--human-bg: #1e2d40;
|
||||||
|
--human-border: #2a4a6e;
|
||||||
|
--claude-bg: #242424;
|
||||||
|
--claude-border: #383838;
|
||||||
|
--code-bg: #1a1a1a;
|
||||||
|
--code-header: #2a2a2a;
|
||||||
|
--link: #60a5fa;
|
||||||
|
--badge-new: #16a34a;
|
||||||
|
--badge-proj: #7c3aed;
|
||||||
|
--shadow: 0 1px 3px rgba(0,0,0,0.4);
|
||||||
|
--radius: 10px;
|
||||||
|
--topbar-h: 52px;
|
||||||
|
}
|
||||||
|
|
||||||
|
[data-theme="light"] {
|
||||||
|
--bg: #f7f5f2;
|
||||||
|
--bg2: #ffffff;
|
||||||
|
--bg3: #f0ede8;
|
||||||
|
--border: #e0dbd4;
|
||||||
|
--text: #1a1a1a;
|
||||||
|
--text2: #555;
|
||||||
|
--text3: #999;
|
||||||
|
--accent: #d97706;
|
||||||
|
--accent-hover: #b45309;
|
||||||
|
--human-bg: #eff6ff;
|
||||||
|
--human-border: #bfdbfe;
|
||||||
|
--claude-bg: #ffffff;
|
||||||
|
--claude-border: #e5e7eb;
|
||||||
|
--code-bg: #f8f8f8;
|
||||||
|
--code-header: #ececec;
|
||||||
|
--link: #2563eb;
|
||||||
|
--badge-new: #15803d;
|
||||||
|
--badge-proj: #6d28d9;
|
||||||
|
--shadow: 0 1px 3px rgba(0,0,0,0.1);
|
||||||
|
}
|
||||||
|
|
||||||
|
html { font-size: 16px; scroll-behavior: smooth; }
|
||||||
|
body {
|
||||||
|
font-family: -apple-system, BlinkMacSystemFont, 'Segoe UI', Roboto, 'Inter', Arial, sans-serif;
|
||||||
|
background: var(--bg);
|
||||||
|
color: var(--text);
|
||||||
|
line-height: 1.65;
|
||||||
|
min-height: 100vh;
|
||||||
|
}
|
||||||
|
|
||||||
|
a { color: var(--link); text-decoration: none; }
|
||||||
|
a:hover { text-decoration: underline; }
|
||||||
|
.muted { color: var(--text2); font-size: 0.875rem; }
|
||||||
|
|
||||||
|
/* ===== Topbar ===== */
|
||||||
|
.topbar {
|
||||||
|
position: sticky; top: 0; z-index: 100;
|
||||||
|
height: var(--topbar-h);
|
||||||
|
background: var(--bg2);
|
||||||
|
border-bottom: 1px solid var(--border);
|
||||||
|
display: flex; align-items: center; gap: 1.5rem;
|
||||||
|
padding: 0 1.5rem;
|
||||||
|
}
|
||||||
|
.topbar-logo {
|
||||||
|
display: flex; align-items: center; gap: 0.5rem;
|
||||||
|
color: var(--text); font-weight: 600; font-size: 1rem;
|
||||||
|
text-decoration: none; white-space: nowrap;
|
||||||
|
}
|
||||||
|
.topbar-logo svg { color: var(--accent); }
|
||||||
|
.topbar-nav { display: flex; align-items: center; gap: 1rem; }
|
||||||
|
.topbar-nav a { color: var(--text2); font-size: 0.9rem; }
|
||||||
|
.topbar-nav a:hover { color: var(--text); text-decoration: none; }
|
||||||
|
.topbar-actions { margin-left: auto; display: flex; align-items: center; gap: 0.5rem; }
|
||||||
|
.icon-btn {
|
||||||
|
background: none; border: none; cursor: pointer;
|
||||||
|
color: var(--text2); padding: 6px; border-radius: 6px;
|
||||||
|
display: flex; align-items: center;
|
||||||
|
}
|
||||||
|
.icon-btn:hover { background: var(--bg3); color: var(--text); }
|
||||||
|
|
||||||
|
/* ===== Layout ===== */
|
||||||
|
.page-wrapper { max-width: 1040px; margin: 0 auto; padding: 2rem 1.25rem 4rem; }
|
||||||
|
.main-content { display: flex; flex-direction: column; gap: 2.5rem; }
|
||||||
|
|
||||||
|
/* ===== Breadcrumbs ===== */
|
||||||
|
.breadcrumbs {
|
||||||
|
display: flex; align-items: center; flex-wrap: wrap; gap: 0.25rem;
|
||||||
|
font-size: 0.85rem; color: var(--text2);
|
||||||
|
}
|
||||||
|
.breadcrumbs a { color: var(--text2); }
|
||||||
|
.breadcrumbs a:hover { color: var(--text); }
|
||||||
|
.bc-sep { color: var(--text3); }
|
||||||
|
|
||||||
|
/* ===== Section ===== */
|
||||||
|
.section-title {
|
||||||
|
font-size: 1.1rem; font-weight: 600; color: var(--text);
|
||||||
|
margin-bottom: 1rem;
|
||||||
|
display: flex; align-items: center; gap: 0.75rem;
|
||||||
|
}
|
||||||
|
.section-link { font-size: 0.85rem; font-weight: 400; color: var(--accent); margin-left: auto; }
|
||||||
|
.section-link:hover { color: var(--accent-hover); }
|
||||||
|
|
||||||
|
/* ===== Stats strip ===== */
|
||||||
|
.stats-strip {
|
||||||
|
display: flex; gap: 1rem; flex-wrap: wrap;
|
||||||
|
background: var(--bg2); border: 1px solid var(--border);
|
||||||
|
border-radius: var(--radius); padding: 1rem 1.5rem;
|
||||||
|
}
|
||||||
|
.stat-item { display: flex; flex-direction: column; align-items: center; flex: 1; min-width: 80px; }
|
||||||
|
.stat-num { font-size: 1.75rem; font-weight: 700; color: var(--accent); line-height: 1; }
|
||||||
|
.stat-lbl { font-size: 0.78rem; color: var(--text2); margin-top: 0.25rem; }
|
||||||
|
|
||||||
|
/* ===== Cards ===== */
|
||||||
|
.card {
|
||||||
|
background: var(--bg2);
|
||||||
|
border: 1px solid var(--border);
|
||||||
|
border-radius: var(--radius);
|
||||||
|
padding: 1.25rem;
|
||||||
|
box-shadow: var(--shadow);
|
||||||
|
}
|
||||||
|
|
||||||
|
/* ===== User card ===== */
|
||||||
|
.user-card { display: flex; align-items: center; gap: 1rem; }
|
||||||
|
.user-avatar {
|
||||||
|
width: 44px; height: 44px; border-radius: 50%;
|
||||||
|
background: var(--accent); color: white;
|
||||||
|
font-weight: 700; font-size: 1.1rem;
|
||||||
|
display: flex; align-items: center; justify-content: center;
|
||||||
|
flex-shrink: 0;
|
||||||
|
}
|
||||||
|
.user-name { font-weight: 600; }
|
||||||
|
.user-email { font-size: 0.85rem; color: var(--text2); }
|
||||||
|
|
||||||
|
/* ===== Projects grid ===== */
|
||||||
|
.projects-grid {
|
||||||
|
display: grid;
|
||||||
|
grid-template-columns: repeat(auto-fill, minmax(280px, 1fr));
|
||||||
|
gap: 1rem;
|
||||||
|
}
|
||||||
|
.project-card {
|
||||||
|
background: var(--bg2); border: 1px solid var(--border);
|
||||||
|
border-radius: var(--radius); padding: 1.1rem 1.25rem;
|
||||||
|
text-decoration: none; color: var(--text);
|
||||||
|
transition: border-color 0.15s, box-shadow 0.15s;
|
||||||
|
display: flex; flex-direction: column; gap: 0.4rem;
|
||||||
|
}
|
||||||
|
.project-card:hover {
|
||||||
|
border-color: var(--accent); box-shadow: 0 0 0 1px var(--accent);
|
||||||
|
text-decoration: none;
|
||||||
|
}
|
||||||
|
.pc-name { font-weight: 600; font-size: 0.95rem; }
|
||||||
|
.pc-desc { font-size: 0.82rem; color: var(--text2); line-height: 1.4; }
|
||||||
|
.pc-meta { font-size: 0.78rem; color: var(--text3); display: flex; gap: 0.75rem; flex-wrap: wrap; margin-top: 0.25rem; }
|
||||||
|
|
||||||
|
/* ===== Conversation list (compact rows) ===== */
|
||||||
|
.conv-list { display: flex; flex-direction: column; gap: 0.375rem; }
|
||||||
|
.conv-row {
|
||||||
|
display: flex; justify-content: space-between; align-items: center;
|
||||||
|
padding: 0.6rem 0.875rem;
|
||||||
|
background: var(--bg2); border: 1px solid var(--border);
|
||||||
|
border-radius: 8px; text-decoration: none; color: var(--text);
|
||||||
|
transition: border-color 0.12s;
|
||||||
|
gap: 1rem;
|
||||||
|
}
|
||||||
|
.conv-row:hover { border-color: var(--accent); text-decoration: none; }
|
||||||
|
.conv-row-name { font-size: 0.9rem; flex: 1; min-width: 0; overflow: hidden; text-overflow: ellipsis; white-space: nowrap; }
|
||||||
|
.conv-row-meta { font-size: 0.78rem; color: var(--text2); white-space: nowrap; flex-shrink: 0; }
|
||||||
|
|
||||||
|
/* ===== Badges ===== */
|
||||||
|
.badge {
|
||||||
|
display: inline-block; padding: 1px 7px; border-radius: 20px;
|
||||||
|
font-size: 0.7rem; font-weight: 600; text-transform: uppercase;
|
||||||
|
letter-spacing: 0.03em;
|
||||||
|
}
|
||||||
|
.badge-new { background: var(--badge-new); color: #fff; }
|
||||||
|
.badge-proj { background: var(--badge-proj); color: #fff; }
|
||||||
|
.count-badge {
|
||||||
|
font-size: 0.78rem; color: var(--text2); font-weight: 400;
|
||||||
|
background: var(--bg3); border-radius: 20px; padding: 1px 8px;
|
||||||
|
}
|
||||||
|
|
||||||
|
/* ===== All conversations grid ===== */
|
||||||
|
.filters-bar {
|
||||||
|
display: flex; flex-wrap: wrap; gap: 0.625rem; align-items: center;
|
||||||
|
}
|
||||||
|
.search-input, .select-input {
|
||||||
|
background: var(--bg2); border: 1px solid var(--border);
|
||||||
|
color: var(--text); border-radius: 8px; padding: 0.5rem 0.75rem;
|
||||||
|
font-size: 0.875rem; outline: none;
|
||||||
|
}
|
||||||
|
.search-input { flex: 1; min-width: 200px; }
|
||||||
|
.search-input:focus, .select-input:focus { border-color: var(--accent); }
|
||||||
|
.filter-count { font-size: 0.82rem; color: var(--text2); margin-left: auto; }
|
||||||
|
|
||||||
|
.conv-grid { display: flex; flex-direction: column; gap: 0.5rem; }
|
||||||
|
.conv-card {
|
||||||
|
background: var(--bg2); border: 1px solid var(--border);
|
||||||
|
border-radius: var(--radius); padding: 0.875rem 1rem;
|
||||||
|
text-decoration: none; color: var(--text);
|
||||||
|
transition: border-color 0.12s;
|
||||||
|
display: flex; flex-direction: column; gap: 0.3rem;
|
||||||
|
}
|
||||||
|
.conv-card:hover { border-color: var(--accent); text-decoration: none; }
|
||||||
|
.cc-top { display: flex; align-items: center; gap: 0.5rem; }
|
||||||
|
.cc-name { font-size: 0.9rem; font-weight: 500; flex: 1; }
|
||||||
|
.cc-badges { display: flex; gap: 0.3rem; flex-shrink: 0; }
|
||||||
|
.cc-preview { font-size: 0.82rem; color: var(--text2); white-space: nowrap; overflow: hidden; text-overflow: ellipsis; }
|
||||||
|
.cc-meta { font-size: 0.75rem; color: var(--text3); }
|
||||||
|
|
||||||
|
/* ===== Sync panel ===== */
|
||||||
|
.sync-panel { display: flex; flex-direction: column; gap: 0.75rem; }
|
||||||
|
.sync-panel-header { display: flex; align-items: center; justify-content: space-between; }
|
||||||
|
.sync-status { font-size: 0.82rem; color: var(--text2); }
|
||||||
|
.sync-desc { font-size: 0.85rem; color: var(--text2); line-height: 1.5; }
|
||||||
|
.sync-actions { display: flex; gap: 0.75rem; flex-wrap: wrap; }
|
||||||
|
|
||||||
|
/* ===== Buttons ===== */
|
||||||
|
.btn {
|
||||||
|
padding: 0.45rem 1rem; border-radius: 7px; font-size: 0.85rem;
|
||||||
|
border: 1px solid var(--border); background: var(--bg3);
|
||||||
|
color: var(--text); cursor: pointer; transition: background 0.12s;
|
||||||
|
}
|
||||||
|
.btn:hover { background: var(--border); }
|
||||||
|
.btn-primary { background: var(--accent); border-color: var(--accent); color: white; }
|
||||||
|
.btn-primary:hover { background: var(--accent-hover); border-color: var(--accent-hover); }
|
||||||
|
|
||||||
|
/* ===== Project page ===== */
|
||||||
|
.meta-card { }
|
||||||
|
.project-desc { color: var(--text2); margin-bottom: 0.75rem; font-size: 0.95rem; }
|
||||||
|
.meta-grid {
|
||||||
|
display: grid; grid-template-columns: auto 1fr; gap: 0.4rem 1.25rem;
|
||||||
|
font-size: 0.875rem;
|
||||||
|
}
|
||||||
|
.meta-lbl { color: var(--text2); font-weight: 500; }
|
||||||
|
|
||||||
|
.docs-list { display: flex; flex-direction: column; gap: 0.5rem; }
|
||||||
|
.doc-block {
|
||||||
|
background: var(--bg2); border: 1px solid var(--border);
|
||||||
|
border-radius: var(--radius); overflow: hidden;
|
||||||
|
}
|
||||||
|
.doc-summary {
|
||||||
|
display: flex; align-items: center; gap: 0.6rem;
|
||||||
|
padding: 0.75rem 1rem; cursor: pointer; list-style: none;
|
||||||
|
user-select: none;
|
||||||
|
}
|
||||||
|
.doc-summary:hover { background: var(--bg3); }
|
||||||
|
.doc-name { font-weight: 500; font-size: 0.9rem; flex: 1; }
|
||||||
|
.doc-date { font-size: 0.78rem; }
|
||||||
|
.doc-content { padding: 1rem 1.25rem; border-top: 1px solid var(--border); }
|
||||||
|
|
||||||
|
.prompt-content {
|
||||||
|
background: var(--bg3); border-left: 3px solid var(--accent);
|
||||||
|
padding: 0.875rem 1rem; border-radius: 0 6px 6px 0;
|
||||||
|
font-size: 0.9rem;
|
||||||
|
}
|
||||||
|
|
||||||
|
/* ===== Conversation page ===== */
|
||||||
|
.conv-page { gap: 1.25rem; }
|
||||||
|
.conv-header { display: flex; flex-direction: column; gap: 0.75rem; }
|
||||||
|
.conv-title { font-size: 1.3rem; font-weight: 700; line-height: 1.3; }
|
||||||
|
.conv-meta-bar {
|
||||||
|
display: flex; flex-wrap: wrap; gap: 1rem;
|
||||||
|
font-size: 0.8rem; color: var(--text2);
|
||||||
|
padding: 0.6rem 0; border-top: 1px solid var(--border); border-bottom: 1px solid var(--border);
|
||||||
|
}
|
||||||
|
.conv-uuid { font-family: monospace; font-size: 0.72rem; }
|
||||||
|
|
||||||
|
|
||||||
|
/* Messages */
|
||||||
|
.messages-container { display: flex; flex-direction: column; gap: 1.25rem; }
|
||||||
|
|
||||||
|
.message { display: flex; flex-direction: column; gap: 0.5rem; }
|
||||||
|
.msg-meta { display: flex; align-items: center; gap: 0.5rem; }
|
||||||
|
.msg-avatar {
|
||||||
|
width: 28px; height: 28px; border-radius: 50%;
|
||||||
|
display: flex; align-items: center; justify-content: center;
|
||||||
|
flex-shrink: 0;
|
||||||
|
}
|
||||||
|
.avatar-human { background: #2a4a6e; color: #93c5fd; }
|
||||||
|
.avatar-claude { background: #3a2a1a; color: var(--accent); }
|
||||||
|
.msg-sender { font-weight: 600; font-size: 0.875rem; }
|
||||||
|
.msg-ts { font-size: 0.75rem; color: var(--text3); }
|
||||||
|
|
||||||
|
.msg-body {
|
||||||
|
padding: 0.875rem 1rem;
|
||||||
|
border-radius: 0 var(--radius) var(--radius) var(--radius);
|
||||||
|
border: 1px solid var(--border);
|
||||||
|
}
|
||||||
|
.msg-human .msg-body {
|
||||||
|
background: var(--human-bg); border-color: var(--human-border);
|
||||||
|
margin-left: 2rem;
|
||||||
|
}
|
||||||
|
.msg-claude .msg-body {
|
||||||
|
background: var(--claude-bg); border-color: var(--claude-border);
|
||||||
|
margin-left: 2rem;
|
||||||
|
}
|
||||||
|
|
||||||
|
/* Message content prose */
|
||||||
|
.msg-content { font-size: 0.92rem; line-height: 1.7; }
|
||||||
|
.msg-content p { margin-bottom: 0.6rem; }
|
||||||
|
.msg-content p:last-child { margin-bottom: 0; }
|
||||||
|
.msg-content h1,.msg-content h2,.msg-content h3,
|
||||||
|
.msg-content h4,.msg-content h5,.msg-content h6 {
|
||||||
|
margin: 1rem 0 0.4rem; font-weight: 600;
|
||||||
|
}
|
||||||
|
.msg-content ul, .msg-content ol { margin: 0.4rem 0 0.6rem 1.4rem; }
|
||||||
|
.msg-content li { margin-bottom: 0.2rem; }
|
||||||
|
.msg-content blockquote {
|
||||||
|
border-left: 3px solid var(--accent);
|
||||||
|
margin: 0.6rem 0; padding: 0.4rem 0.875rem;
|
||||||
|
background: var(--bg3); border-radius: 0 6px 6px 0;
|
||||||
|
color: var(--text2);
|
||||||
|
}
|
||||||
|
.msg-content a { color: var(--link); }
|
||||||
|
.msg-content hr { border: none; border-top: 1px solid var(--border); margin: 0.75rem 0; }
|
||||||
|
.msg-content strong { font-weight: 700; }
|
||||||
|
.msg-content em { font-style: italic; }
|
||||||
|
.msg-content del { text-decoration: line-through; color: var(--text2); }
|
||||||
|
|
||||||
|
/* Code */
|
||||||
|
.inline-code {
|
||||||
|
font-family: 'JetBrains Mono', 'Fira Code', 'Cascadia Code', Consolas, monospace;
|
||||||
|
font-size: 0.82em;
|
||||||
|
background: var(--code-bg);
|
||||||
|
border: 1px solid var(--border);
|
||||||
|
border-radius: 4px;
|
||||||
|
padding: 1px 5px;
|
||||||
|
color: #f59e0b;
|
||||||
|
}
|
||||||
|
.code-block {
|
||||||
|
background: var(--code-bg); border: 1px solid var(--border);
|
||||||
|
border-radius: var(--radius); overflow: hidden; margin: 0.75rem 0;
|
||||||
|
}
|
||||||
|
.code-header {
|
||||||
|
display: flex; justify-content: space-between; align-items: center;
|
||||||
|
padding: 0.4rem 0.875rem;
|
||||||
|
background: var(--code-header);
|
||||||
|
border-bottom: 1px solid var(--border);
|
||||||
|
}
|
||||||
|
.code-lang { font-size: 0.75rem; color: var(--text2); font-family: monospace; }
|
||||||
|
.copy-btn {
|
||||||
|
font-size: 0.75rem; color: var(--text2); background: none;
|
||||||
|
border: 1px solid var(--border); border-radius: 5px;
|
||||||
|
padding: 2px 8px; cursor: pointer;
|
||||||
|
}
|
||||||
|
.copy-btn:hover { background: var(--border); color: var(--text); }
|
||||||
|
.copy-btn.copied { color: #16a34a; border-color: #16a34a; }
|
||||||
|
.code-block pre {
|
||||||
|
overflow-x: auto; padding: 0.875rem 1rem;
|
||||||
|
font-family: 'JetBrains Mono', 'Fira Code', Consolas, monospace;
|
||||||
|
font-size: 0.82rem; line-height: 1.6;
|
||||||
|
}
|
||||||
|
.code-block code { background: none; border: none; padding: 0; font-size: inherit; color: var(--text); }
|
||||||
|
|
||||||
|
/* Syntax highlight */
|
||||||
|
.hl-keyword { color: #c084fc; font-weight: 500; }
|
||||||
|
.hl-string { color: #86efac; }
|
||||||
|
.hl-number { color: #fb923c; }
|
||||||
|
.hl-comment { color: #6b7280; font-style: italic; }
|
||||||
|
|
||||||
|
/* Attachments */
|
||||||
|
.msg-attachments { margin-top: 0.75rem; display: flex; flex-direction: column; gap: 0.4rem; }
|
||||||
|
.attachment {
|
||||||
|
background: var(--bg3); border: 1px solid var(--border); border-radius: 8px; overflow: hidden;
|
||||||
|
}
|
||||||
|
.att-summary {
|
||||||
|
display: flex; align-items: center; gap: 0.5rem;
|
||||||
|
padding: 0.5rem 0.75rem; cursor: pointer; list-style: none;
|
||||||
|
}
|
||||||
|
.att-summary:hover { background: var(--border); }
|
||||||
|
.att-badge { display: flex; align-items: center; gap: 0.5rem; padding: 0.5rem 0.75rem; }
|
||||||
|
.att-name { font-size: 0.82rem; font-weight: 500; }
|
||||||
|
.att-meta { font-size: 0.75rem; color: var(--text3); }
|
||||||
|
.att-content { padding: 0.75rem 1rem; border-top: 1px solid var(--border); font-size: 0.85rem; }
|
||||||
|
|
||||||
|
/* ===== Tables ===== */
|
||||||
|
.table-wrap { overflow-x: auto; margin: 0.75rem 0; border-radius: var(--radius); border: 1px solid var(--border); }
|
||||||
|
.table-wrap table { width: 100%; border-collapse: collapse; font-size: 0.875rem; }
|
||||||
|
.table-wrap th {
|
||||||
|
background: var(--bg3); color: var(--text);
|
||||||
|
font-weight: 600; text-align: left;
|
||||||
|
padding: 0.55rem 0.875rem;
|
||||||
|
border-bottom: 2px solid var(--border);
|
||||||
|
white-space: nowrap;
|
||||||
|
}
|
||||||
|
.table-wrap td {
|
||||||
|
padding: 0.5rem 0.875rem;
|
||||||
|
border-bottom: 1px solid var(--border);
|
||||||
|
color: var(--text);
|
||||||
|
vertical-align: top;
|
||||||
|
}
|
||||||
|
.table-wrap tr:last-child td { border-bottom: none; }
|
||||||
|
.table-wrap tr:hover td { background: var(--bg3); }
|
||||||
|
|
||||||
|
/* ===== Scroll FAB buttons ===== */
|
||||||
|
.scroll-fabs {
|
||||||
|
position: fixed;
|
||||||
|
right: 1.5rem;
|
||||||
|
bottom: 2rem;
|
||||||
|
display: flex;
|
||||||
|
flex-direction: column;
|
||||||
|
gap: 0.5rem;
|
||||||
|
z-index: 200;
|
||||||
|
}
|
||||||
|
.scroll-fab {
|
||||||
|
width: 40px; height: 40px;
|
||||||
|
border-radius: 50%;
|
||||||
|
background: var(--bg2);
|
||||||
|
border: 1px solid var(--border);
|
||||||
|
color: var(--text2);
|
||||||
|
cursor: pointer;
|
||||||
|
display: flex; align-items: center; justify-content: center;
|
||||||
|
box-shadow: 0 2px 8px rgba(0,0,0,0.35);
|
||||||
|
transition: background 0.15s, color 0.15s, opacity 0.2s;
|
||||||
|
opacity: 0.75;
|
||||||
|
}
|
||||||
|
.scroll-fab:hover { background: var(--accent); border-color: var(--accent); color: #fff; opacity: 1; }
|
||||||
|
.scroll-fab.hidden { opacity: 0; pointer-events: none; }
|
||||||
|
|
||||||
|
/* ===== Topbar divider (between nav links and assign widget) ===== */
|
||||||
|
.topbar-divider {
|
||||||
|
width: 1px; height: 18px;
|
||||||
|
background: var(--border);
|
||||||
|
margin: 0 0.5rem;
|
||||||
|
flex-shrink: 0;
|
||||||
|
}
|
||||||
|
|
||||||
|
/* ===== Topbar assign widget (sits inside topbar-nav) ===== */
|
||||||
|
.topbar-assign {
|
||||||
|
display: flex; align-items: center; gap: 0.5rem;
|
||||||
|
}
|
||||||
|
.topbar-assign-label { font-size: 0.8rem; color: var(--text2); white-space: nowrap; }
|
||||||
|
.topbar-assign .select-input { font-size: 0.8rem; padding: 0.3rem 0.6rem; max-width: 200px; }
|
||||||
|
.topbar-assign-link { font-size: 0.8rem; color: var(--accent); white-space: nowrap; }
|
||||||
|
.topbar-assign-link:hover { color: var(--accent-hover); }
|
||||||
|
|
||||||
|
/* ===== Language toggle ===== */
|
||||||
|
.lang-toggle {
|
||||||
|
display: flex; gap: 0; border: 1px solid var(--border); border-radius: 6px; overflow: hidden;
|
||||||
|
}
|
||||||
|
.lang-btn {
|
||||||
|
background: none; border: none; cursor: pointer;
|
||||||
|
color: var(--text2); font-size: 0.78rem; font-weight: 600;
|
||||||
|
padding: 4px 9px; transition: background 0.12s, color 0.12s;
|
||||||
|
}
|
||||||
|
.lang-btn.active { background: var(--accent); color: #fff; }
|
||||||
|
.lang-btn:not(.active):hover { background: var(--bg3); color: var(--text); }
|
||||||
|
|
||||||
|
/* ===== i18n hidden ===== */
|
||||||
|
[data-lang] { display: none; }
|
||||||
|
[data-lang].lang-visible { display: inline; }
|
||||||
|
[data-lang-block] { display: none; }
|
||||||
|
[data-lang-block].lang-visible { display: block; }
|
||||||
|
|
||||||
|
/* ===== Gen note ===== */
|
||||||
|
.gen-note { font-size: 0.78rem; color: var(--text3); }
|
||||||
|
|
||||||
|
/* ===== Responsive ===== */
|
||||||
|
@media (max-width: 640px) {
|
||||||
|
.page-wrapper { padding: 1rem 0.875rem 3rem; }
|
||||||
|
.topbar { padding: 0 1rem; gap: 0.75rem; }
|
||||||
|
.topbar-nav { display: none; }
|
||||||
|
.topbar-assign .select-input { max-width: 130px; }
|
||||||
|
.topbar-divider { display: none; }
|
||||||
|
.stats-strip { gap: 0.5rem; padding: 0.875rem 1rem; }
|
||||||
|
.stat-num { font-size: 1.4rem; }
|
||||||
|
.projects-grid { grid-template-columns: 1fr; }
|
||||||
|
.conv-row { flex-direction: column; align-items: flex-start; gap: 0.2rem; }
|
||||||
|
.conv-row-meta { align-self: flex-end; }
|
||||||
|
.msg-human .msg-body, .msg-claude .msg-body { margin-left: 0; }
|
||||||
|
.scroll-fabs { right: 0.75rem; bottom: 1rem; }
|
||||||
|
}
|
||||||
127
declaude/cli.py
Normal file
127
declaude/cli.py
Normal file
|
|
@ -0,0 +1,127 @@
|
||||||
|
"""Command-line interface: declaude --build | --update ZIP | --remap | --map CONV PROJ."""
|
||||||
|
from __future__ import annotations
|
||||||
|
|
||||||
|
import argparse
|
||||||
|
import shutil
|
||||||
|
import sys
|
||||||
|
from pathlib import Path
|
||||||
|
|
||||||
|
from .loader import DataLoader, MappingManager, extract_zip
|
||||||
|
from .site import SiteBuilder
|
||||||
|
|
||||||
|
OUTPUT_DIR = Path("claude_archive")
|
||||||
|
MAPPING_FILE = Path("mapping.json")
|
||||||
|
|
||||||
|
|
||||||
|
# ---------------------------------------------------------------------------
|
||||||
|
# main
|
||||||
|
# ---------------------------------------------------------------------------
|
||||||
|
|
||||||
|
def main() -> None:
|
||||||
|
parser = argparse.ArgumentParser(
|
||||||
|
description="declaude — Claude backup → static HTML archive",
|
||||||
|
formatter_class=argparse.RawDescriptionHelpFormatter,
|
||||||
|
epilog="""
|
||||||
|
Commands:
|
||||||
|
--build Generate full archive from backup directory
|
||||||
|
--update path/to/new.zip Merge new backup zip, regenerate changed pages only
|
||||||
|
--remap Rebuild index + project pages after editing mapping.json
|
||||||
|
--map CONV_UUID PROJ_UUID Assign a conversation to a project in mapping.json
|
||||||
|
|
||||||
|
Source options:
|
||||||
|
--source PATH Path to backup directory (default: ./claude-backup-v1)
|
||||||
|
--output PATH Output directory (default: ./claude_archive)
|
||||||
|
--mapping PATH mapping.json path (default: ./mapping.json)
|
||||||
|
|
||||||
|
Examples:
|
||||||
|
python declaude.py --build
|
||||||
|
python declaude.py --build --source ./my-backup --output ./my-archive
|
||||||
|
python declaude.py --update new_export.zip
|
||||||
|
python declaude.py --remap
|
||||||
|
python declaude.py --map abc123 proj456
|
||||||
|
"""
|
||||||
|
)
|
||||||
|
parser.add_argument("--build", action="store_true", help="Full build from source")
|
||||||
|
parser.add_argument("--update", metavar="ZIP", help="Update from new zip archive")
|
||||||
|
parser.add_argument("--remap", action="store_true", help="Rebuild index/project pages after mapping change")
|
||||||
|
parser.add_argument("--map", nargs=2, metavar=("CONV_UUID","PROJ_UUID"),
|
||||||
|
help="Assign conversation to project in mapping.json")
|
||||||
|
parser.add_argument("--source", default="claude-backup-v1", metavar="PATH",
|
||||||
|
help="Source backup directory (default: claude-backup-v1)")
|
||||||
|
parser.add_argument("--output", default=str(OUTPUT_DIR), metavar="PATH",
|
||||||
|
help=f"Output directory (default: {OUTPUT_DIR})")
|
||||||
|
parser.add_argument("--mapping", default=str(MAPPING_FILE), metavar="PATH",
|
||||||
|
help=f"Mapping file path (default: {MAPPING_FILE})")
|
||||||
|
|
||||||
|
args = parser.parse_args()
|
||||||
|
|
||||||
|
out_dir = Path(args.output)
|
||||||
|
mapping_path = Path(args.mapping)
|
||||||
|
source_dir = Path(args.source)
|
||||||
|
|
||||||
|
# Load mapping (always)
|
||||||
|
mapping = MappingManager(mapping_path)
|
||||||
|
mapping.load()
|
||||||
|
|
||||||
|
# --map: just add one entry and exit
|
||||||
|
if args.map:
|
||||||
|
conv_uuid, proj_uuid = args.map
|
||||||
|
mapping.assign(conv_uuid, proj_uuid)
|
||||||
|
mapping.save()
|
||||||
|
print(f"Mapped conversation {conv_uuid} -> project {proj_uuid}")
|
||||||
|
print(f"Saved to {mapping_path}. Run --remap to rebuild project pages.")
|
||||||
|
return
|
||||||
|
|
||||||
|
# --remap: load data, rebuild index + project pages
|
||||||
|
if args.remap:
|
||||||
|
print(f"Loading data from {source_dir}...")
|
||||||
|
loader = DataLoader(source_dir)
|
||||||
|
loader.load()
|
||||||
|
site = SiteBuilder(out_dir, loader, mapping)
|
||||||
|
site.build_remap()
|
||||||
|
mapping.save()
|
||||||
|
return
|
||||||
|
|
||||||
|
# --update: load existing + new zip, merge
|
||||||
|
if args.update:
|
||||||
|
zip_path = Path(args.update)
|
||||||
|
if not zip_path.exists():
|
||||||
|
print(f"Error: {zip_path} not found.")
|
||||||
|
sys.exit(1)
|
||||||
|
|
||||||
|
print(f"Loading existing data from {source_dir}...")
|
||||||
|
old_loader = DataLoader(source_dir)
|
||||||
|
old_loader.load()
|
||||||
|
|
||||||
|
print(f"Extracting {zip_path}...")
|
||||||
|
tmp_dir = Path("_declaude_tmp")
|
||||||
|
new_source = extract_zip(zip_path, tmp_dir)
|
||||||
|
print(f"Loading new data from {new_source}...")
|
||||||
|
new_loader = DataLoader(new_source)
|
||||||
|
new_loader.load()
|
||||||
|
|
||||||
|
site = SiteBuilder(out_dir, old_loader, mapping)
|
||||||
|
site.build_update(new_loader)
|
||||||
|
mapping.save()
|
||||||
|
|
||||||
|
# Clean up temp dir
|
||||||
|
shutil.rmtree(tmp_dir, ignore_errors=True)
|
||||||
|
return
|
||||||
|
|
||||||
|
# --build (default if nothing specified or --build explicit)
|
||||||
|
if args.build or not any([args.remap, args.update, args.map]):
|
||||||
|
if not source_dir.exists():
|
||||||
|
print(f"Error: source directory '{source_dir}' not found.")
|
||||||
|
print("Use --source to specify the backup directory.")
|
||||||
|
sys.exit(1)
|
||||||
|
print(f"Loading data from {source_dir}...")
|
||||||
|
loader = DataLoader(source_dir)
|
||||||
|
loader.load()
|
||||||
|
site = SiteBuilder(out_dir, loader, mapping)
|
||||||
|
site.build_all()
|
||||||
|
mapping.save()
|
||||||
|
return
|
||||||
|
|
||||||
|
parser.print_help()
|
||||||
|
|
||||||
|
|
||||||
621
declaude/html.py
Normal file
621
declaude/html.py
Normal file
|
|
@ -0,0 +1,621 @@
|
||||||
|
"""HTML page templates for the archive."""
|
||||||
|
from __future__ import annotations
|
||||||
|
|
||||||
|
import re
|
||||||
|
from datetime import datetime
|
||||||
|
from typing import Dict, List, Optional, Tuple
|
||||||
|
|
||||||
|
from .loader import DataLoader, MappingManager
|
||||||
|
from .markdown import MarkdownRenderer
|
||||||
|
|
||||||
|
|
||||||
|
# ---------------------------------------------------------------------------
|
||||||
|
# HtmlBuilder — page templates
|
||||||
|
# ---------------------------------------------------------------------------
|
||||||
|
|
||||||
|
class HtmlBuilder:
|
||||||
|
"""Builds complete HTML pages as strings."""
|
||||||
|
|
||||||
|
def __init__(self, md: MarkdownRenderer):
|
||||||
|
self.md = md
|
||||||
|
|
||||||
|
# --- Shared helpers --------------------------------------------------- #
|
||||||
|
|
||||||
|
def _page(self, title: str, body: str, depth: int = 0,
|
||||||
|
extra_head: str = "", conv_assign_html: str = "") -> str:
|
||||||
|
root = "../" * depth
|
||||||
|
return f"""<!DOCTYPE html>
|
||||||
|
<html lang="ru" data-theme="dark">
|
||||||
|
<head>
|
||||||
|
<meta charset="UTF-8">
|
||||||
|
<meta name="viewport" content="width=device-width, initial-scale=1.0">
|
||||||
|
<title>{self._esc(title)} — Claude Archive</title>
|
||||||
|
<link rel="stylesheet" href="{root}assets/style.css">
|
||||||
|
{extra_head}
|
||||||
|
</head>
|
||||||
|
<body>
|
||||||
|
{self._topbar(root, conv_assign_html)}
|
||||||
|
<div class="page-wrapper">
|
||||||
|
{body}
|
||||||
|
</div>
|
||||||
|
<script src="{root}assets/app.js"></script>
|
||||||
|
</body>
|
||||||
|
</html>"""
|
||||||
|
|
||||||
|
def _topbar(self, root: str, conv_assign_html: str = "") -> str:
|
||||||
|
# conv_assign_html is injected right after the nav links, separated by a visual divider
|
||||||
|
assign_block = (
|
||||||
|
f'<div class="topbar-divider"></div>{conv_assign_html}'
|
||||||
|
if conv_assign_html else ""
|
||||||
|
)
|
||||||
|
return f"""<header class="topbar">
|
||||||
|
<a class="topbar-logo" href="{root}index.html">
|
||||||
|
<svg width="22" height="22" viewBox="0 0 24 24" fill="none" stroke="currentColor" stroke-width="2">
|
||||||
|
<circle cx="12" cy="12" r="10"/><path d="M12 6v6l4 2"/>
|
||||||
|
</svg>
|
||||||
|
Claude Archive
|
||||||
|
</a>
|
||||||
|
<nav class="topbar-nav">
|
||||||
|
<a href="{root}all_conversations.html"><span data-lang="ru" class="lang-visible">Все чаты</span><span data-lang="en">All chats</span></a>
|
||||||
|
<a href="{root}index.html#projects"><span data-lang="ru" class="lang-visible">Проекты</span><span data-lang="en">Projects</span></a>
|
||||||
|
{assign_block}
|
||||||
|
</nav>
|
||||||
|
<div class="topbar-actions">
|
||||||
|
<div class="lang-toggle">
|
||||||
|
<button class="lang-btn active" id="langRu" onclick="setLang('ru')">RU</button>
|
||||||
|
<button class="lang-btn" id="langEn" onclick="setLang('en')">EN</button>
|
||||||
|
</div>
|
||||||
|
<button class="icon-btn" id="themeToggle" title="Переключить тему" onclick="toggleTheme()">
|
||||||
|
<svg class="icon-moon" width="18" height="18" viewBox="0 0 24 24" fill="none" stroke="currentColor" stroke-width="2">
|
||||||
|
<path d="M21 12.79A9 9 0 1 1 11.21 3 7 7 0 0 0 21 12.79z"/>
|
||||||
|
</svg>
|
||||||
|
<svg class="icon-sun" width="18" height="18" viewBox="0 0 24 24" fill="none" stroke="currentColor" stroke-width="2" style="display:none">
|
||||||
|
<circle cx="12" cy="12" r="5"/><line x1="12" y1="1" x2="12" y2="3"/>
|
||||||
|
<line x1="12" y1="21" x2="12" y2="23"/><line x1="4.22" y1="4.22" x2="5.64" y2="5.64"/>
|
||||||
|
<line x1="18.36" y1="18.36" x2="19.78" y2="19.78"/><line x1="1" y1="12" x2="3" y2="12"/>
|
||||||
|
<line x1="21" y1="12" x2="23" y2="12"/><line x1="4.22" y1="19.78" x2="5.64" y2="18.36"/>
|
||||||
|
<line x1="18.36" y1="5.64" x2="19.78" y2="4.22"/>
|
||||||
|
</svg>
|
||||||
|
</button>
|
||||||
|
</div>
|
||||||
|
</header>"""
|
||||||
|
|
||||||
|
def _esc(self, text) -> str:
|
||||||
|
if text is None:
|
||||||
|
return ""
|
||||||
|
return (str(text)
|
||||||
|
.replace("&", "&")
|
||||||
|
.replace("<", "<")
|
||||||
|
.replace(">", ">")
|
||||||
|
.replace('"', """))
|
||||||
|
|
||||||
|
# Breadcrumb label translations for fixed UI strings
|
||||||
|
_BC_I18N: Dict[str, Tuple[str, str]] = {
|
||||||
|
"Главная": ("Главная", "Home"),
|
||||||
|
"Все чаты": ("Все чаты", "All chats"),
|
||||||
|
"Проекты": ("Проекты", "Projects"),
|
||||||
|
"Проект": ("Проект", "Project"),
|
||||||
|
}
|
||||||
|
|
||||||
|
def _breadcrumbs(self, crumbs: List[Tuple[str, Optional[str]]]) -> str:
|
||||||
|
parts = []
|
||||||
|
for label, href in crumbs:
|
||||||
|
if label in self._BC_I18N:
|
||||||
|
ru, en = self._BC_I18N[label]
|
||||||
|
inner = (
|
||||||
|
f'<span data-lang="ru" class="lang-visible">{self._esc(ru)}</span>'
|
||||||
|
f'<span data-lang="en">{self._esc(en)}</span>'
|
||||||
|
)
|
||||||
|
else:
|
||||||
|
inner = self._esc(label)
|
||||||
|
if href:
|
||||||
|
parts.append(f'<a href="{href}">{inner}</a>')
|
||||||
|
else:
|
||||||
|
parts.append(f'<span>{inner}</span>')
|
||||||
|
return '<nav class="breadcrumbs">' + '<span class="bc-sep">›</span>'.join(parts) + '</nav>'
|
||||||
|
|
||||||
|
def _format_date(self, iso: str, short: bool = False) -> str:
|
||||||
|
if not iso:
|
||||||
|
return "—"
|
||||||
|
try:
|
||||||
|
if iso.endswith("Z"):
|
||||||
|
iso = iso[:-1] + "+00:00"
|
||||||
|
dt = datetime.fromisoformat(iso)
|
||||||
|
if short:
|
||||||
|
return dt.strftime("%d.%m.%Y")
|
||||||
|
return dt.strftime("%d.%m.%Y %H:%M")
|
||||||
|
except Exception:
|
||||||
|
return iso
|
||||||
|
|
||||||
|
def _conv_display_name(self, conv: Dict) -> str:
|
||||||
|
name = conv.get("name", "").strip()
|
||||||
|
if name:
|
||||||
|
return name
|
||||||
|
msgs = conv.get("chat_messages", [])
|
||||||
|
for msg in msgs:
|
||||||
|
if msg.get("sender") == "human":
|
||||||
|
text = msg.get("text", "")
|
||||||
|
if not text:
|
||||||
|
for block in msg.get("content", []):
|
||||||
|
if block.get("type") == "text":
|
||||||
|
text = block.get("text", "")
|
||||||
|
break
|
||||||
|
if text:
|
||||||
|
clean = re.sub(r"\s+", " ", text).strip()
|
||||||
|
return clean[:60] + ("..." if len(clean) > 60 else "")
|
||||||
|
uid = conv.get("uuid", "")
|
||||||
|
return f"Чат {uid[-8:]}" if uid else "Без названия"
|
||||||
|
|
||||||
|
def _conv_preview(self, conv: Dict, max_len: int = 120) -> str:
|
||||||
|
msgs = conv.get("chat_messages", [])
|
||||||
|
for msg in msgs:
|
||||||
|
if msg.get("sender") == "human":
|
||||||
|
text = msg.get("text", "")
|
||||||
|
if not text:
|
||||||
|
for block in msg.get("content", []):
|
||||||
|
if block.get("type") == "text":
|
||||||
|
text = block.get("text", "")
|
||||||
|
break
|
||||||
|
if text:
|
||||||
|
clean = re.sub(r"```[\s\S]*?```", "[код]", text)
|
||||||
|
clean = re.sub(r"`[^`]+`", "[код]", clean)
|
||||||
|
clean = re.sub(r"\s+", " ", clean).strip()
|
||||||
|
return clean[:max_len] + ("..." if len(clean) > max_len else "")
|
||||||
|
return ""
|
||||||
|
|
||||||
|
# --- Index page ------------------------------------------------------- #
|
||||||
|
|
||||||
|
def build_index(self, loader: DataLoader, mapping: MappingManager,
|
||||||
|
meta: Dict, new_uuids: set) -> str:
|
||||||
|
user = loader.user
|
||||||
|
convs = loader.conversations
|
||||||
|
projects = loader.projects
|
||||||
|
|
||||||
|
total_msgs = sum(len(c.get("chat_messages", [])) for c in convs)
|
||||||
|
gen_time = datetime.now().strftime("%d.%m.%Y %H:%M")
|
||||||
|
|
||||||
|
# stats strip
|
||||||
|
stats_html = f"""<div class="stats-strip">
|
||||||
|
<div class="stat-item"><span class="stat-num">{len(convs)}</span><span class="stat-lbl"><span data-lang="ru" class="lang-visible">чатов</span><span data-lang="en">chats</span></span></div>
|
||||||
|
<div class="stat-item"><span class="stat-num">{total_msgs}</span><span class="stat-lbl"><span data-lang="ru" class="lang-visible">сообщений</span><span data-lang="en">messages</span></span></div>
|
||||||
|
<div class="stat-item"><span class="stat-num">{len(projects)}</span><span class="stat-lbl"><span data-lang="ru" class="lang-visible">проектов</span><span data-lang="en">projects</span></span></div>
|
||||||
|
<div class="stat-item"><span class="stat-num">{len(mapping.data)}</span><span class="stat-lbl"><span data-lang="ru" class="lang-visible">привязано</span><span data-lang="en">mapped</span></span></div>
|
||||||
|
</div>"""
|
||||||
|
|
||||||
|
# user info
|
||||||
|
user_html = ""
|
||||||
|
if user:
|
||||||
|
user_html = f"""<div class="card user-card">
|
||||||
|
<div class="user-avatar">{self._esc(user.get('full_name','?')[:1])}</div>
|
||||||
|
<div>
|
||||||
|
<div class="user-name">{self._esc(user.get('full_name','Unknown'))}</div>
|
||||||
|
<div class="user-email">{self._esc(user.get('email_address',''))}</div>
|
||||||
|
</div>
|
||||||
|
</div>"""
|
||||||
|
|
||||||
|
# projects grid
|
||||||
|
sorted_projects = sorted(projects.values(), key=lambda p: p.get("updated_at",""), reverse=True)
|
||||||
|
project_cards = ""
|
||||||
|
for proj in sorted_projects:
|
||||||
|
pid = proj.get("uuid","")
|
||||||
|
pname = self._esc(proj.get("name","Без названия"))
|
||||||
|
pdesc = self._esc(proj.get("description","") or "")
|
||||||
|
pdocs = len(proj.get("docs",[]))
|
||||||
|
pcnt = len(mapping.conversations_for_project(pid))
|
||||||
|
pupdated = self._format_date(proj.get("updated_at",""), short=True)
|
||||||
|
project_cards += f"""<a class="project-card" href="projects/{pid}/index.html">
|
||||||
|
<div class="pc-name">{pname}</div>
|
||||||
|
{f'<div class="pc-desc">{pdesc}</div>' if pdesc else ''}
|
||||||
|
<div class="pc-meta">
|
||||||
|
<span>{pdocs} doc{'s' if pdocs!=1 else ''}</span>
|
||||||
|
<span>{pcnt} чат{'а' if pcnt in(2,3,4) else 'ов' if pcnt!=1 else ''}</span>
|
||||||
|
<span>{pupdated}</span>
|
||||||
|
</div>
|
||||||
|
</a>"""
|
||||||
|
|
||||||
|
# recent conversations
|
||||||
|
recent = sorted(convs, key=lambda c: c.get("updated_at",""), reverse=True)[:15]
|
||||||
|
recent_rows = ""
|
||||||
|
for conv in recent:
|
||||||
|
cid = conv.get("uuid","")
|
||||||
|
cname = self._esc(self._conv_display_name(conv))
|
||||||
|
cupdated = self._format_date(conv.get("updated_at",""))
|
||||||
|
cmsg = len(conv.get("chat_messages",[]))
|
||||||
|
cproj_uuid = mapping.get_project(cid)
|
||||||
|
cproj_name = ""
|
||||||
|
if cproj_uuid and cproj_uuid in loader.projects:
|
||||||
|
cproj_name = self._esc(loader.projects[cproj_uuid].get("name",""))
|
||||||
|
is_new = cid in new_uuids
|
||||||
|
new_badge = '<span class="badge badge-new">new</span>' if is_new else ""
|
||||||
|
proj_badge = f'<span class="badge badge-proj">{cproj_name}</span>' if cproj_name else ""
|
||||||
|
recent_rows += f"""<a class="conv-row" href="conversations/{cid}.html">
|
||||||
|
<span class="conv-row-name">{cname} {new_badge} {proj_badge}</span>
|
||||||
|
<span class="conv-row-meta">{cmsg} сообщ. · {cupdated}</span>
|
||||||
|
</a>"""
|
||||||
|
|
||||||
|
# mapping sync panel
|
||||||
|
sync_panel = """<div class="sync-panel card" id="syncPanel">
|
||||||
|
<div class="sync-panel-header">
|
||||||
|
<strong><span data-lang="ru" class="lang-visible">Синхронизация маппинга</span><span data-lang="en">Mapping sync</span></strong>
|
||||||
|
<span class="sync-status" id="syncStatus"></span>
|
||||||
|
</div>
|
||||||
|
<p class="sync-desc">
|
||||||
|
<span data-lang="ru" class="lang-visible">Привязки чатов к проектам, сделанные в браузере, хранятся в localStorage.
|
||||||
|
Нажмите «Экспорт», скачайте файл, положите рядом со скриптом как <code>mapping.json</code>,
|
||||||
|
затем запустите <code>python declaude.py --remap</code>.</span>
|
||||||
|
<span data-lang="en">Browser-side project assignments are stored in localStorage.
|
||||||
|
Click Export, save the file next to the script as <code>mapping.json</code>,
|
||||||
|
then run <code>python declaude.py --remap</code>.</span>
|
||||||
|
</p>
|
||||||
|
<div class="sync-actions">
|
||||||
|
<button class="btn btn-primary" onclick="exportMapping()">
|
||||||
|
<span data-lang="ru" class="lang-visible">Экспорт mapping.json</span>
|
||||||
|
<span data-lang="en">Export mapping.json</span>
|
||||||
|
</button>
|
||||||
|
<button class="btn" onclick="clearBrowserMapping()">
|
||||||
|
<span data-lang="ru" class="lang-visible">Сбросить браузерный маппинг</span>
|
||||||
|
<span data-lang="en">Reset browser mapping</span>
|
||||||
|
</button>
|
||||||
|
</div>
|
||||||
|
</div>"""
|
||||||
|
|
||||||
|
body = f"""<main class="main-content">
|
||||||
|
{user_html}
|
||||||
|
{stats_html}
|
||||||
|
<p class="gen-note"><span data-lang="ru" class="lang-visible">Архив сгенерирован:</span><span data-lang="en">Archive generated:</span> {gen_time}</p>
|
||||||
|
|
||||||
|
<section id="projects">
|
||||||
|
<h2 class="section-title"><span data-lang="ru" class="lang-visible">Проекты</span><span data-lang="en">Projects</span></h2>
|
||||||
|
<div class="projects-grid">{project_cards if project_cards else '<p class="muted"><span data-lang="ru" class="lang-visible">Нет проектов в архиве.</span><span data-lang="en">No projects in archive.</span></p>'}</div>
|
||||||
|
</section>
|
||||||
|
|
||||||
|
<section id="recent">
|
||||||
|
<h2 class="section-title">
|
||||||
|
<span data-lang="ru" class="lang-visible">Последние чаты</span><span data-lang="en">Recent chats</span>
|
||||||
|
<a href="all_conversations.html" class="section-link"><span data-lang="ru" class="lang-visible">Все →</span><span data-lang="en">All →</span></a>
|
||||||
|
</h2>
|
||||||
|
<div class="conv-list">{recent_rows}</div>
|
||||||
|
</section>
|
||||||
|
|
||||||
|
<section id="sync">
|
||||||
|
<h2 class="section-title"><span data-lang="ru" class="lang-visible">Синхронизация маппинга</span><span data-lang="en">Mapping sync</span></h2>
|
||||||
|
{sync_panel}
|
||||||
|
</section>
|
||||||
|
</main>"""
|
||||||
|
|
||||||
|
return self._page("Архив", body, depth=0)
|
||||||
|
|
||||||
|
# --- All conversations page ------------------------------------------- #
|
||||||
|
|
||||||
|
def build_all_conversations(self, loader: DataLoader, mapping: MappingManager,
|
||||||
|
new_uuids: set) -> str:
|
||||||
|
convs = loader.conversations
|
||||||
|
projects = loader.projects
|
||||||
|
|
||||||
|
sorted_convs = sorted(convs, key=lambda c: c.get("updated_at",""), reverse=True)
|
||||||
|
|
||||||
|
# Build project filter options (data-ru/data-en for JS i18n since <option> can't have child spans)
|
||||||
|
proj_options = '<option value="" data-ru="Все проекты" data-en="All projects">Все проекты</option>'
|
||||||
|
proj_options += '<option value="__none__" data-ru="Без проекта" data-en="No project">Без проекта</option>'
|
||||||
|
for proj in sorted(projects.values(), key=lambda p: p.get("name","")):
|
||||||
|
pid = proj.get("uuid","")
|
||||||
|
pname = self._esc(proj.get("name",""))
|
||||||
|
proj_options += f'<option value="{pid}">{pname}</option>'
|
||||||
|
|
||||||
|
rows_html = ""
|
||||||
|
for conv in sorted_convs:
|
||||||
|
cid = conv.get("uuid","")
|
||||||
|
cname = self._esc(self._conv_display_name(conv))
|
||||||
|
cpreview = self._esc(self._conv_preview(conv))
|
||||||
|
cupdated = self._format_date(conv.get("updated_at",""))
|
||||||
|
ccreated = self._format_date(conv.get("created_at",""), short=True)
|
||||||
|
cmsg = len(conv.get("chat_messages",[]))
|
||||||
|
cproj_uuid = mapping.get_project(cid) or ""
|
||||||
|
cproj_name = ""
|
||||||
|
if cproj_uuid and cproj_uuid in projects:
|
||||||
|
cproj_name = self._esc(projects[cproj_uuid].get("name",""))
|
||||||
|
is_new = cid in new_uuids
|
||||||
|
new_badge = '<span class="badge badge-new">new</span>' if is_new else ""
|
||||||
|
proj_badge = f'<span class="badge badge-proj">{cproj_name}</span>' if cproj_name else ""
|
||||||
|
|
||||||
|
rows_html += f"""<a class="conv-card"
|
||||||
|
href="conversations/{cid}.html"
|
||||||
|
data-name="{cname.lower()}"
|
||||||
|
data-preview="{cpreview.lower()}"
|
||||||
|
data-proj="{cproj_uuid}"
|
||||||
|
data-updated="{conv.get('updated_at','')}"
|
||||||
|
data-created="{conv.get('created_at','')}"
|
||||||
|
data-msgs="{cmsg}">
|
||||||
|
<div class="cc-top">
|
||||||
|
<span class="cc-name">{cname}</span>
|
||||||
|
<span class="cc-badges">{new_badge}{proj_badge}</span>
|
||||||
|
</div>
|
||||||
|
{f'<div class="cc-preview">{cpreview}</div>' if cpreview else ''}
|
||||||
|
<div class="cc-meta">{cmsg} <span data-lang="ru" class="lang-visible">сообщ.</span><span data-lang="en">msg</span> · {cupdated} · <span data-lang="ru" class="lang-visible">создан</span><span data-lang="en">created</span> {ccreated}</div>
|
||||||
|
</a>"""
|
||||||
|
|
||||||
|
body = f"""<main class="main-content">
|
||||||
|
{self._breadcrumbs([("Главная","index.html"),("Все чаты",None)])}
|
||||||
|
<h1>
|
||||||
|
<span data-lang="ru" class="lang-visible">Все чаты</span>
|
||||||
|
<span data-lang="en">All chats</span>
|
||||||
|
<span class="count-badge">{len(convs)}</span>
|
||||||
|
</h1>
|
||||||
|
|
||||||
|
<div class="filters-bar">
|
||||||
|
<input type="search" id="searchInput"
|
||||||
|
data-placeholder-ru="Поиск по названию или тексту..."
|
||||||
|
data-placeholder-en="Search by title or text..."
|
||||||
|
placeholder="Поиск по названию или тексту..."
|
||||||
|
class="search-input" oninput="filterConvs()">
|
||||||
|
<select id="projFilter" class="select-input" onchange="filterConvs()">
|
||||||
|
{proj_options}
|
||||||
|
</select>
|
||||||
|
<select id="sortSelect" class="select-input" onchange="filterConvs()">
|
||||||
|
<option value="updated" data-ru="По дате обновления" data-en="By update date">По дате обновления</option>
|
||||||
|
<option value="created" data-ru="По дате создания" data-en="By creation date">По дате создания</option>
|
||||||
|
<option value="msgs" data-ru="По числу сообщений" data-en="By message count">По числу сообщений</option>
|
||||||
|
</select>
|
||||||
|
<span id="countLabel" class="filter-count"></span>
|
||||||
|
</div>
|
||||||
|
|
||||||
|
<div class="conv-grid" id="convGrid">
|
||||||
|
{rows_html}
|
||||||
|
</div>
|
||||||
|
</main>"""
|
||||||
|
|
||||||
|
return self._page("Все чаты", body, depth=0,
|
||||||
|
extra_head='<script>window.PAGE_TYPE="all_convs";</script>')
|
||||||
|
|
||||||
|
# --- Project page ----------------------------------------------------- #
|
||||||
|
|
||||||
|
def build_project_page(self, project: Dict, loader: DataLoader,
|
||||||
|
mapping: MappingManager) -> str:
|
||||||
|
pid = project.get("uuid","")
|
||||||
|
pname = project.get("name","Без названия")
|
||||||
|
pdesc = project.get("description","") or ""
|
||||||
|
pcreated = self._format_date(project.get("created_at",""))
|
||||||
|
pupdated = self._format_date(project.get("updated_at",""))
|
||||||
|
pprompt = project.get("prompt_template","") or ""
|
||||||
|
docs = project.get("docs",[])
|
||||||
|
|
||||||
|
# Documents section
|
||||||
|
docs_html = ""
|
||||||
|
if docs:
|
||||||
|
for doc in docs:
|
||||||
|
dname = self._esc(doc.get("filename","Без названия"))
|
||||||
|
dcreated = self._format_date(doc.get("created_at",""))
|
||||||
|
dcontent = doc.get("content","") or ""
|
||||||
|
doc_rendered = self.md.render(dcontent) if dcontent else "<p class='muted'>Нет содержимого.</p>"
|
||||||
|
docs_html += f"""<details class="doc-block">
|
||||||
|
<summary class="doc-summary">
|
||||||
|
<span class="doc-icon">📄</span>
|
||||||
|
<span class="doc-name">{dname}</span>
|
||||||
|
<span class="doc-date muted">{dcreated}</span>
|
||||||
|
</summary>
|
||||||
|
<div class="doc-content">{doc_rendered}</div>
|
||||||
|
</details>"""
|
||||||
|
else:
|
||||||
|
docs_html = '<p class="muted">Нет документов в этом проекте.</p>'
|
||||||
|
|
||||||
|
# Prompt template
|
||||||
|
prompt_html = ""
|
||||||
|
if pprompt:
|
||||||
|
prompt_rendered = self.md.render(pprompt)
|
||||||
|
prompt_html = f"""<section class="card">
|
||||||
|
<h2>Системный промпт</h2>
|
||||||
|
<div class="prompt-content">{prompt_rendered}</div>
|
||||||
|
</section>"""
|
||||||
|
|
||||||
|
# Conversations
|
||||||
|
conv_uuids = mapping.conversations_for_project(pid)
|
||||||
|
conv_map = {c.get("uuid",""): c for c in loader.conversations}
|
||||||
|
proj_convs = [conv_map[u] for u in conv_uuids if u in conv_map]
|
||||||
|
proj_convs.sort(key=lambda c: c.get("updated_at",""), reverse=True)
|
||||||
|
|
||||||
|
conv_rows = ""
|
||||||
|
for conv in proj_convs:
|
||||||
|
cid = conv.get("uuid","")
|
||||||
|
cname = self._esc(self._conv_display_name(conv))
|
||||||
|
cpreview = self._esc(self._conv_preview(conv))
|
||||||
|
cupdated = self._format_date(conv.get("updated_at",""))
|
||||||
|
cmsg = len(conv.get("chat_messages",[]))
|
||||||
|
conv_rows += f"""<a class="conv-row" href="../../conversations/{cid}.html">
|
||||||
|
<span class="conv-row-name">{cname}</span>
|
||||||
|
<span class="conv-row-meta">{cmsg} сообщ. · {cupdated}</span>
|
||||||
|
</a>
|
||||||
|
{f'<div class="conv-row-preview">{cpreview}</div>' if cpreview else ''}"""
|
||||||
|
|
||||||
|
convs_section = f"""<section>
|
||||||
|
<h2>Привязанные чаты <span class="count-badge">{len(proj_convs)}</span></h2>
|
||||||
|
{f'<div class="conv-list">{conv_rows}</div>' if proj_convs else '<p class="muted">Нет привязанных чатов. Откройте чат и нажмите «Привязать к проекту».</p>'}
|
||||||
|
</section>"""
|
||||||
|
|
||||||
|
body = f"""<main class="main-content">
|
||||||
|
{self._breadcrumbs([("Главная","../../index.html"),("Проекты","../../index.html#projects"),(pname,None)])}
|
||||||
|
<h1>{self._esc(pname)}</h1>
|
||||||
|
|
||||||
|
<div class="card meta-card">
|
||||||
|
{f'<p class="project-desc">{self._esc(pdesc)}</p>' if pdesc else ''}
|
||||||
|
<div class="meta-grid">
|
||||||
|
<span class="meta-lbl">Создан</span><span>{pcreated}</span>
|
||||||
|
<span class="meta-lbl">Обновлён</span><span>{pupdated}</span>
|
||||||
|
<span class="meta-lbl">Документов</span><span>{len(docs)}</span>
|
||||||
|
<span class="meta-lbl">Чатов</span><span>{len(proj_convs)}</span>
|
||||||
|
</div>
|
||||||
|
</div>
|
||||||
|
|
||||||
|
{prompt_html}
|
||||||
|
|
||||||
|
<section>
|
||||||
|
<h2>Документы <span class="count-badge">{len(docs)}</span></h2>
|
||||||
|
<div class="docs-list">{docs_html}</div>
|
||||||
|
</section>
|
||||||
|
|
||||||
|
{convs_section}
|
||||||
|
</main>"""
|
||||||
|
|
||||||
|
return self._page(pname, body, depth=2)
|
||||||
|
|
||||||
|
# --- Conversation page ------------------------------------------------ #
|
||||||
|
|
||||||
|
def build_conversation_page(self, conv: Dict, loader: DataLoader,
|
||||||
|
mapping: MappingManager) -> str:
|
||||||
|
cid = conv.get("uuid","")
|
||||||
|
cname = self._conv_display_name(conv)
|
||||||
|
ccreated = self._format_date(conv.get("created_at",""))
|
||||||
|
cupdated = self._format_date(conv.get("updated_at",""))
|
||||||
|
messages = conv.get("chat_messages",[])
|
||||||
|
|
||||||
|
# Sort messages by created_at
|
||||||
|
try:
|
||||||
|
messages = sorted(messages, key=lambda m: m.get("created_at",""))
|
||||||
|
except Exception:
|
||||||
|
pass
|
||||||
|
|
||||||
|
# Current project assignment
|
||||||
|
cproj_uuid = mapping.get_project(cid) or ""
|
||||||
|
|
||||||
|
# Project assignment widget — goes into topbar
|
||||||
|
# Note: <option> can't contain HTML tags, so i18n for the placeholder is done via JS (data-i18n attr)
|
||||||
|
proj_options_html = '<option value="" data-ru="— Не привязан —" data-en="— Not assigned —">— Не привязан —</option>'
|
||||||
|
for proj in sorted(loader.projects.values(), key=lambda p: p.get("name","")):
|
||||||
|
pid2 = proj.get("uuid","")
|
||||||
|
pn = self._esc(proj.get("name",""))
|
||||||
|
selected = 'selected' if pid2 == cproj_uuid else ''
|
||||||
|
proj_options_html += f'<option value="{pid2}" {selected}>{pn}</option>'
|
||||||
|
|
||||||
|
open_proj_link = (
|
||||||
|
f'<a class="topbar-assign-link" id="assignProjLink" href="../projects/{cproj_uuid}/index.html">'
|
||||||
|
f'<span data-lang="ru" class="lang-visible">Открыть →</span>'
|
||||||
|
f'<span data-lang="en">Open →</span>'
|
||||||
|
f'</a>'
|
||||||
|
if cproj_uuid else
|
||||||
|
'<a class="topbar-assign-link" id="assignProjLink" href="#" style="display:none">'
|
||||||
|
'<span data-lang="ru" class="lang-visible">Открыть →</span>'
|
||||||
|
'<span data-lang="en">Open →</span>'
|
||||||
|
'</a>'
|
||||||
|
)
|
||||||
|
|
||||||
|
conv_assign_html = f"""<div class="topbar-assign">
|
||||||
|
<span class="topbar-assign-label">
|
||||||
|
<span data-lang="ru" class="lang-visible">Проект:</span>
|
||||||
|
<span data-lang="en">Project:</span>
|
||||||
|
</span>
|
||||||
|
<select id="projSelect" class="select-input" onchange="assignProject('{cid}', this.value)">
|
||||||
|
{proj_options_html}
|
||||||
|
</select>
|
||||||
|
{open_proj_link}
|
||||||
|
</div>"""
|
||||||
|
|
||||||
|
# FAB scroll buttons
|
||||||
|
scroll_fabs = """<div class="scroll-fabs" id="scrollFabs">
|
||||||
|
<button class="scroll-fab hidden" id="fabTop" onclick="scrollToTop()" title="В начало">
|
||||||
|
<svg width="16" height="16" viewBox="0 0 24 24" fill="none" stroke="currentColor" stroke-width="2.5">
|
||||||
|
<polyline points="18 15 12 9 6 15"/>
|
||||||
|
</svg>
|
||||||
|
</button>
|
||||||
|
<button class="scroll-fab" id="fabBottom" onclick="scrollToBottom()" title="В конец">
|
||||||
|
<svg width="16" height="16" viewBox="0 0 24 24" fill="none" stroke="currentColor" stroke-width="2.5">
|
||||||
|
<polyline points="6 9 12 15 18 9"/>
|
||||||
|
</svg>
|
||||||
|
</button>
|
||||||
|
</div>"""
|
||||||
|
|
||||||
|
# Messages
|
||||||
|
msgs_html = ""
|
||||||
|
for i, msg in enumerate(messages):
|
||||||
|
sender = msg.get("sender","unknown")
|
||||||
|
ts = self._format_date(msg.get("created_at",""))
|
||||||
|
text = msg.get("text","")
|
||||||
|
if not text:
|
||||||
|
parts = []
|
||||||
|
for block in msg.get("content",[]):
|
||||||
|
if isinstance(block, dict) and block.get("type") == "text":
|
||||||
|
parts.append(block.get("text",""))
|
||||||
|
text = "\n".join(parts)
|
||||||
|
|
||||||
|
attachments = msg.get("attachments",[])
|
||||||
|
files = msg.get("files",[])
|
||||||
|
|
||||||
|
rendered = self.md.render(text) if text else (
|
||||||
|
'<p class="muted">'
|
||||||
|
'<span data-lang="ru" class="lang-visible">[нет текста]</span>'
|
||||||
|
'<span data-lang="en">[no text]</span>'
|
||||||
|
'</p>'
|
||||||
|
)
|
||||||
|
|
||||||
|
# Attachments
|
||||||
|
attach_html = ""
|
||||||
|
for att in attachments:
|
||||||
|
fname = self._esc(att.get("file_name","файл"))
|
||||||
|
fsize = att.get("file_size",0)
|
||||||
|
ftype = self._esc(att.get("file_type","") or "")
|
||||||
|
extracted = att.get("extracted_content","") or ""
|
||||||
|
size_str = f"{fsize:,}".replace(",", " ") + " б" if fsize else ""
|
||||||
|
if extracted:
|
||||||
|
ext_rendered = self.md.render(extracted)
|
||||||
|
attach_html += f"""<details class="attachment">
|
||||||
|
<summary class="att-summary">
|
||||||
|
<span class="att-icon">📎</span>
|
||||||
|
<span class="att-name">{fname}</span>
|
||||||
|
{f'<span class="att-meta">{ftype} · {size_str}</span>' if ftype or size_str else ''}
|
||||||
|
</summary>
|
||||||
|
<div class="att-content">{ext_rendered}</div>
|
||||||
|
</details>"""
|
||||||
|
else:
|
||||||
|
attach_html += f"""<div class="attachment att-badge">
|
||||||
|
<span class="att-icon">📎</span>
|
||||||
|
<span class="att-name">{fname}</span>
|
||||||
|
{f'<span class="att-meta">{ftype} · {size_str}</span>' if ftype or size_str else ''}
|
||||||
|
</div>"""
|
||||||
|
|
||||||
|
for fobj in files:
|
||||||
|
fname = self._esc(fobj.get("file_name","файл"))
|
||||||
|
attach_html += f'<div class="attachment att-badge"><span class="att-icon">📁</span> <span class="att-name">{fname}</span></div>'
|
||||||
|
|
||||||
|
is_human = sender == "human"
|
||||||
|
role_cls = "msg-human" if is_human else "msg-claude"
|
||||||
|
avatar = f"""<div class="msg-avatar {'avatar-human' if is_human else 'avatar-claude'}">
|
||||||
|
{'<svg width="16" height="16" viewBox="0 0 24 24" fill="currentColor"><path d="M12 12c2.7 0 4.8-2.1 4.8-4.8S14.7 2.4 12 2.4 7.2 4.5 7.2 7.2 9.3 12 12 12zm0 2.4c-3.2 0-9.6 1.6-9.6 4.8v2.4h19.2v-2.4c0-3.2-6.4-4.8-9.6-4.8z"/></svg>' if is_human else '<svg width="16" height="16" viewBox="0 0 24 24" fill="none" stroke="currentColor" stroke-width="2"><circle cx="12" cy="12" r="10"/><path d="M12 6v6l4 2"/></svg>'}
|
||||||
|
</div>"""
|
||||||
|
sender_label_html = (
|
||||||
|
'<span data-lang="ru" class="lang-visible">Вы</span><span data-lang="en">You</span>'
|
||||||
|
if is_human else "Claude"
|
||||||
|
)
|
||||||
|
|
||||||
|
msgs_html += f"""<div class="message {role_cls}" id="msg-{i}">
|
||||||
|
<div class="msg-meta">
|
||||||
|
{avatar}
|
||||||
|
<span class="msg-sender">{sender_label_html}</span>
|
||||||
|
<span class="msg-ts">{ts}</span>
|
||||||
|
</div>
|
||||||
|
<div class="msg-body">
|
||||||
|
<div class="msg-content">{rendered}</div>
|
||||||
|
{f'<div class="msg-attachments">{attach_html}</div>' if attach_html else ''}
|
||||||
|
</div>
|
||||||
|
</div>"""
|
||||||
|
|
||||||
|
body = f"""<main class="main-content conv-page">
|
||||||
|
{self._breadcrumbs([("Главная","../index.html"),("Все чаты","../all_conversations.html"),(cname,None)])}
|
||||||
|
<h1 class="conv-title">{self._esc(cname)}</h1>
|
||||||
|
<div class="conv-meta-bar">
|
||||||
|
<span><span data-lang="ru" class="lang-visible">Создан:</span><span data-lang="en">Created:</span> {ccreated}</span>
|
||||||
|
<span><span data-lang="ru" class="lang-visible">Обновлён:</span><span data-lang="en">Updated:</span> {cupdated}</span>
|
||||||
|
<span>{len(messages)} <span data-lang="ru" class="lang-visible">сообщений</span><span data-lang="en">messages</span></span>
|
||||||
|
<span class="conv-uuid muted">ID: {cid}</span>
|
||||||
|
</div>
|
||||||
|
|
||||||
|
<div class="messages-container" id="messagesContainer">
|
||||||
|
{msgs_html}
|
||||||
|
</div>
|
||||||
|
{scroll_fabs}
|
||||||
|
</main>"""
|
||||||
|
|
||||||
|
return self._page(
|
||||||
|
cname, body, depth=1,
|
||||||
|
extra_head=f'<script>window.CONV_UUID="{cid}";window.PAGE_TYPE="conversation";</script>',
|
||||||
|
conv_assign_html=conv_assign_html
|
||||||
|
)
|
||||||
|
|
||||||
|
|
||||||
141
declaude/loader.py
Normal file
141
declaude/loader.py
Normal file
|
|
@ -0,0 +1,141 @@
|
||||||
|
"""Loading a Claude.ai data export and the conversation → project mapping."""
|
||||||
|
from __future__ import annotations
|
||||||
|
|
||||||
|
import json
|
||||||
|
import shutil
|
||||||
|
import sys
|
||||||
|
import zipfile
|
||||||
|
from pathlib import Path
|
||||||
|
from typing import Dict, List, Optional
|
||||||
|
|
||||||
|
BACKUP_CONVERSATIONS = "conversations.json"
|
||||||
|
BACKUP_USERS = "users.json"
|
||||||
|
BACKUP_PROJECTS_DIR = "projects"
|
||||||
|
|
||||||
|
|
||||||
|
# ---------------------------------------------------------------------------
|
||||||
|
# DataLoader
|
||||||
|
# ---------------------------------------------------------------------------
|
||||||
|
|
||||||
|
class DataLoader:
|
||||||
|
"""Loads and validates Claude backup data from a directory."""
|
||||||
|
|
||||||
|
def __init__(self, source_dir: Path):
|
||||||
|
self.source_dir = source_dir
|
||||||
|
self.conversations: List[Dict] = []
|
||||||
|
self.projects: Dict[str, Dict] = {} # uuid → project
|
||||||
|
self.user: Dict = {}
|
||||||
|
|
||||||
|
def load(self) -> None:
|
||||||
|
self._load_user()
|
||||||
|
self._load_projects()
|
||||||
|
self._load_conversations()
|
||||||
|
|
||||||
|
def _load_user(self) -> None:
|
||||||
|
path = self.source_dir / BACKUP_USERS
|
||||||
|
if not path.exists():
|
||||||
|
return
|
||||||
|
try:
|
||||||
|
with open(path, encoding="utf-8") as f:
|
||||||
|
data = json.load(f)
|
||||||
|
if isinstance(data, list) and data:
|
||||||
|
self.user = data[0]
|
||||||
|
elif isinstance(data, dict):
|
||||||
|
self.user = data
|
||||||
|
except Exception as e:
|
||||||
|
print(f" Warning: could not load users.json: {e}")
|
||||||
|
|
||||||
|
def _load_projects(self) -> None:
|
||||||
|
projects_dir = self.source_dir / BACKUP_PROJECTS_DIR
|
||||||
|
if not projects_dir.is_dir():
|
||||||
|
print(f" Warning: projects/ directory not found in {self.source_dir}")
|
||||||
|
return
|
||||||
|
for json_file in projects_dir.glob("*.json"):
|
||||||
|
try:
|
||||||
|
with open(json_file, encoding="utf-8") as f:
|
||||||
|
data = json.load(f)
|
||||||
|
if isinstance(data, dict) and "uuid" in data:
|
||||||
|
self.projects[data["uuid"]] = data
|
||||||
|
except Exception as e:
|
||||||
|
print(f" Warning: could not load {json_file.name}: {e}")
|
||||||
|
print(f" Loaded {len(self.projects)} projects")
|
||||||
|
|
||||||
|
def _load_conversations(self) -> None:
|
||||||
|
path = self.source_dir / BACKUP_CONVERSATIONS
|
||||||
|
if not path.exists():
|
||||||
|
print(f"Error: {path} not found.")
|
||||||
|
sys.exit(1)
|
||||||
|
try:
|
||||||
|
with open(path, encoding="utf-8") as f:
|
||||||
|
data = json.load(f)
|
||||||
|
if not isinstance(data, list):
|
||||||
|
print("Error: conversations.json is not a JSON array.")
|
||||||
|
sys.exit(1)
|
||||||
|
self.conversations = data
|
||||||
|
except Exception as e:
|
||||||
|
print(f"Error loading conversations.json: {e}")
|
||||||
|
sys.exit(1)
|
||||||
|
print(f" Loaded {len(self.conversations)} conversations")
|
||||||
|
|
||||||
|
|
||||||
|
# ---------------------------------------------------------------------------
|
||||||
|
# MappingManager
|
||||||
|
# ---------------------------------------------------------------------------
|
||||||
|
|
||||||
|
class MappingManager:
|
||||||
|
"""Manages conv_uuid → project_uuid mapping with persistence."""
|
||||||
|
|
||||||
|
def __init__(self, mapping_path: Path):
|
||||||
|
self.path = mapping_path
|
||||||
|
self.data: Dict[str, str] = {} # conv_uuid → project_uuid
|
||||||
|
|
||||||
|
def load(self) -> None:
|
||||||
|
if not self.path.exists():
|
||||||
|
return
|
||||||
|
try:
|
||||||
|
with open(self.path, encoding="utf-8") as f:
|
||||||
|
raw = json.load(f)
|
||||||
|
if isinstance(raw, dict):
|
||||||
|
self.data = {str(k): str(v) for k, v in raw.items()}
|
||||||
|
except Exception as e:
|
||||||
|
print(f" Warning: could not load mapping.json: {e}")
|
||||||
|
|
||||||
|
def save(self) -> None:
|
||||||
|
with open(self.path, "w", encoding="utf-8") as f:
|
||||||
|
json.dump(self.data, f, ensure_ascii=False, indent=2)
|
||||||
|
|
||||||
|
def assign(self, conv_uuid: str, project_uuid: str) -> None:
|
||||||
|
self.data[conv_uuid] = project_uuid
|
||||||
|
|
||||||
|
def get_project(self, conv_uuid: str) -> Optional[str]:
|
||||||
|
return self.data.get(conv_uuid)
|
||||||
|
|
||||||
|
def conversations_for_project(self, project_uuid: str) -> List[str]:
|
||||||
|
return [c for c, p in self.data.items() if p == project_uuid]
|
||||||
|
|
||||||
|
def merge_from_browser(self, browser_export: Dict[str, str]) -> int:
|
||||||
|
"""Merge browser localStorage export into mapping. Returns count of new entries."""
|
||||||
|
added = 0
|
||||||
|
for conv_uuid, proj_uuid in browser_export.items():
|
||||||
|
if conv_uuid not in self.data:
|
||||||
|
self.data[conv_uuid] = proj_uuid
|
||||||
|
added += 1
|
||||||
|
return added
|
||||||
|
|
||||||
|
|
||||||
|
# ---------------------------------------------------------------------------
|
||||||
|
# Zip extraction helper
|
||||||
|
# ---------------------------------------------------------------------------
|
||||||
|
|
||||||
|
def extract_zip(zip_path: Path, target_dir: Path) -> Path:
|
||||||
|
"""Extract zip archive to target_dir, return the root directory inside."""
|
||||||
|
if target_dir.exists():
|
||||||
|
shutil.rmtree(target_dir)
|
||||||
|
target_dir.mkdir(parents=True)
|
||||||
|
with zipfile.ZipFile(zip_path, "r") as zf:
|
||||||
|
zf.extractall(target_dir)
|
||||||
|
# If zip has a single root folder, use that
|
||||||
|
children = list(target_dir.iterdir())
|
||||||
|
if len(children) == 1 and children[0].is_dir():
|
||||||
|
return children[0]
|
||||||
|
return target_dir
|
||||||
340
declaude/markdown.py
Normal file
340
declaude/markdown.py
Normal file
|
|
@ -0,0 +1,340 @@
|
||||||
|
"""Minimal Markdown → HTML renderer with code highlighting, tables and safe links."""
|
||||||
|
from __future__ import annotations
|
||||||
|
|
||||||
|
import html
|
||||||
|
import re
|
||||||
|
from typing import List
|
||||||
|
|
||||||
|
|
||||||
|
# ---------------------------------------------------------------------------
|
||||||
|
# MarkdownRenderer
|
||||||
|
# ---------------------------------------------------------------------------
|
||||||
|
|
||||||
|
_SCHEME = re.compile(r"^([a-z][a-z0-9+.\-]*):")
|
||||||
|
_LINK_SCHEMES = ("http", "https", "mailto")
|
||||||
|
|
||||||
|
|
||||||
|
def _safe_url(url: str, image: bool = False) -> str:
|
||||||
|
"""Allow only http(s)/mailto links and relative URLs; javascript:, data: and the like become "#".
|
||||||
|
|
||||||
|
The text is already HTML-escaped at this point, so the scheme is checked on the unescaped form
|
||||||
|
with control characters and spaces removed (browsers ignore them inside the scheme).
|
||||||
|
"""
|
||||||
|
probe = re.sub(r"[\x00-\x20]", "", html.unescape(url)).lower()
|
||||||
|
m = _SCHEME.match(probe)
|
||||||
|
if m is None:
|
||||||
|
return url
|
||||||
|
if m.group(1) in _LINK_SCHEMES and not (image and m.group(1) == "mailto"):
|
||||||
|
return url
|
||||||
|
if image and probe.startswith("data:image/") and not probe.startswith("data:image/svg"):
|
||||||
|
return url
|
||||||
|
return "#"
|
||||||
|
|
||||||
|
|
||||||
|
class MarkdownRenderer:
|
||||||
|
"""
|
||||||
|
Converts markdown text to HTML.
|
||||||
|
Handles: code blocks, inline code, headers, bold, italic,
|
||||||
|
links, images, horizontal rules, blockquotes, unordered/ordered lists.
|
||||||
|
No external dependencies.
|
||||||
|
"""
|
||||||
|
|
||||||
|
# Syntax highlight token patterns per language family
|
||||||
|
_KEYWORDS = {
|
||||||
|
"python": r'\b(def|class|return|import|from|if|elif|else|for|while|with|as|in|not|and|or|is|None|True|False|try|except|finally|raise|yield|lambda|pass|break|continue|del|global|nonlocal|assert|async|await)\b',
|
||||||
|
"js": r'\b(function|const|let|var|return|if|else|for|while|do|class|new|this|import|export|default|from|async|await|try|catch|finally|throw|typeof|instanceof|in|of|true|false|null|undefined|switch|case|break|continue)\b',
|
||||||
|
"ts": r'\b(function|const|let|var|return|if|else|for|while|do|class|new|this|import|export|default|from|async|await|try|catch|finally|throw|typeof|instanceof|in|of|true|false|null|undefined|switch|case|break|continue|type|interface|enum|extends|implements|readonly|abstract)\b',
|
||||||
|
"html": None,
|
||||||
|
"css": None,
|
||||||
|
"sql": r'\b(SELECT|FROM|WHERE|JOIN|LEFT|RIGHT|INNER|OUTER|ON|GROUP|BY|ORDER|HAVING|INSERT|INTO|VALUES|UPDATE|SET|DELETE|CREATE|TABLE|INDEX|DROP|ALTER|ADD|COLUMN|PRIMARY|KEY|FOREIGN|REFERENCES|NOT|NULL|UNIQUE|DEFAULT|AND|OR|AS|DISTINCT|LIMIT|OFFSET|COUNT|SUM|AVG|MAX|MIN|UNION|ALL|EXISTS|IN|LIKE|BETWEEN|CASE|WHEN|THEN|ELSE|END)\b',
|
||||||
|
"bash": r'\b(echo|if|then|else|fi|for|do|done|while|case|esac|function|return|exit|cd|ls|mkdir|rm|cp|mv|cat|grep|sed|awk|find|chmod|chown|export|source|alias|unset|set|read|printf|test|true|false)\b',
|
||||||
|
"go": r'\b(func|package|import|var|const|type|struct|interface|map|chan|go|defer|select|switch|case|default|return|if|else|for|range|break|continue|fallthrough|nil|true|false|make|new|len|cap|append|copy|delete|close|panic|recover)\b',
|
||||||
|
"rust": r'\b(fn|let|mut|pub|use|mod|struct|enum|impl|trait|for|while|loop|if|else|match|return|break|continue|true|false|None|Some|Ok|Err|self|Self|super|crate|move|ref|in|as|where|async|await|dyn|unsafe|extern)\b',
|
||||||
|
}
|
||||||
|
|
||||||
|
_LANG_ALIASES = {
|
||||||
|
"javascript": "js", "typescript": "ts", "jsx": "js", "tsx": "ts",
|
||||||
|
"shell": "bash", "sh": "bash", "zsh": "bash",
|
||||||
|
"py": "python", "golang": "go",
|
||||||
|
}
|
||||||
|
|
||||||
|
def render(self, text: str) -> str:
|
||||||
|
if not text:
|
||||||
|
return ""
|
||||||
|
|
||||||
|
# 1. Extract and protect code blocks
|
||||||
|
code_blocks: List[str] = []
|
||||||
|
text = re.sub(
|
||||||
|
r'```(\w*)\n?([\s\S]*?)```',
|
||||||
|
lambda m: self._store_code(m, code_blocks),
|
||||||
|
text
|
||||||
|
)
|
||||||
|
|
||||||
|
# 2. Escape HTML in the remaining text
|
||||||
|
text = self._escape_html(text)
|
||||||
|
|
||||||
|
# 3. Inline code (protect from further processing)
|
||||||
|
inline_codes: List[str] = []
|
||||||
|
text = re.sub(
|
||||||
|
r'`([^`\n]+)`',
|
||||||
|
lambda m: self._store_inline(m, inline_codes),
|
||||||
|
text
|
||||||
|
)
|
||||||
|
|
||||||
|
# 4a. Tables (before line-by-line block processing)
|
||||||
|
text = self._process_tables(text)
|
||||||
|
|
||||||
|
# 4. Block-level elements (process line by line)
|
||||||
|
text = self._process_block(text)
|
||||||
|
|
||||||
|
# 5. Inline formatting
|
||||||
|
text = self._process_inline(text)
|
||||||
|
|
||||||
|
# 6. Restore inline code
|
||||||
|
for i, code in enumerate(inline_codes):
|
||||||
|
text = text.replace(f'\x02INLINE{i}\x03', code)
|
||||||
|
|
||||||
|
# 7. Restore code blocks
|
||||||
|
for i, block in enumerate(code_blocks):
|
||||||
|
text = text.replace(f'\x02CODE{i}\x03', block)
|
||||||
|
|
||||||
|
return text
|
||||||
|
|
||||||
|
def _store_code(self, m: re.Match, store: List[str]) -> str:
|
||||||
|
lang_raw = m.group(1).strip().lower()
|
||||||
|
lang = self._LANG_ALIASES.get(lang_raw, lang_raw)
|
||||||
|
code = m.group(2)
|
||||||
|
highlighted = self._highlight(self._escape_html(code), lang)
|
||||||
|
lang_label = lang_raw or "code"
|
||||||
|
html = (
|
||||||
|
f'<div class="code-block">'
|
||||||
|
f'<div class="code-header">'
|
||||||
|
f'<span class="code-lang">{lang_label}</span>'
|
||||||
|
f'<button class="copy-btn" onclick="copyCode(this)">Copy</button>'
|
||||||
|
f'</div>'
|
||||||
|
f'<pre><code class="lang-{lang}">{highlighted}</code></pre>'
|
||||||
|
f'</div>'
|
||||||
|
)
|
||||||
|
idx = len(store)
|
||||||
|
store.append(html)
|
||||||
|
return f'\x02CODE{idx}\x03'
|
||||||
|
|
||||||
|
def _store_inline(self, m: re.Match, store: List[str]) -> str:
|
||||||
|
code = m.group(1)
|
||||||
|
html = f'<code class="inline-code">{code}</code>'
|
||||||
|
idx = len(store)
|
||||||
|
store.append(html)
|
||||||
|
return f'\x02INLINE{idx}\x03'
|
||||||
|
|
||||||
|
def _highlight(self, code: str, lang: str) -> str:
|
||||||
|
if lang not in self._KEYWORDS:
|
||||||
|
return code
|
||||||
|
pattern = self._KEYWORDS[lang]
|
||||||
|
if not pattern:
|
||||||
|
return code
|
||||||
|
# Strings
|
||||||
|
code = re.sub(r'("(?:[^\\&#]|\\.)*?"|'(?:[^\\&#]|\\.)*?')',
|
||||||
|
r'<span class="hl-string">\1</span>', code)
|
||||||
|
# Keywords
|
||||||
|
code = re.sub(pattern, r'<span class="hl-keyword">\1</span>', code,
|
||||||
|
flags=re.IGNORECASE if lang == "sql" else 0)
|
||||||
|
# Numbers
|
||||||
|
code = re.sub(r'\b(\d+\.?\d*)\b', r'<span class="hl-number">\1</span>', code)
|
||||||
|
# Comments
|
||||||
|
if lang in ("python", "bash"):
|
||||||
|
code = re.sub(r'(#[^\n]*)', r'<span class="hl-comment">\1</span>', code)
|
||||||
|
elif lang in ("js", "ts", "go", "rust", "css"):
|
||||||
|
code = re.sub(r'(//[^\n]*)', r'<span class="hl-comment">\1</span>', code)
|
||||||
|
code = re.sub(r'(/\*[\s\S]*?\*/)', r'<span class="hl-comment">\1</span>', code)
|
||||||
|
elif lang == "sql":
|
||||||
|
code = re.sub(r'(--[^\n]*)', r'<span class="hl-comment">\1</span>', code)
|
||||||
|
return code
|
||||||
|
|
||||||
|
def _escape_html(self, text: str) -> str:
|
||||||
|
text = text.replace("&", "&")
|
||||||
|
text = text.replace("<", "<")
|
||||||
|
text = text.replace(">", ">")
|
||||||
|
return text
|
||||||
|
|
||||||
|
def _process_tables(self, text: str) -> str:
|
||||||
|
"""Convert GFM pipe tables to HTML tables."""
|
||||||
|
lines = text.split('\n')
|
||||||
|
result: List[str] = []
|
||||||
|
i = 0
|
||||||
|
while i < len(lines):
|
||||||
|
# A table starts with a pipe line followed by a separator line (---|---)
|
||||||
|
if (i + 1 < len(lines)
|
||||||
|
and '|' in lines[i]
|
||||||
|
and re.match(r'^\s*\|?[\s\-:|]+\|[\s\-:|]*\|?\s*$', lines[i + 1])):
|
||||||
|
# Collect header row
|
||||||
|
header_line = lines[i].strip().strip('|')
|
||||||
|
sep_line = lines[i + 1]
|
||||||
|
i += 2
|
||||||
|
|
||||||
|
# Parse alignments from separator
|
||||||
|
sep_cells = [c.strip() for c in sep_line.strip().strip('|').split('|')]
|
||||||
|
aligns: List[str] = []
|
||||||
|
for cell in sep_cells:
|
||||||
|
if cell.startswith(':') and cell.endswith(':'):
|
||||||
|
aligns.append(' style="text-align:center"')
|
||||||
|
elif cell.endswith(':'):
|
||||||
|
aligns.append(' style="text-align:right"')
|
||||||
|
else:
|
||||||
|
aligns.append('')
|
||||||
|
|
||||||
|
# Render header
|
||||||
|
header_cells = [c.strip() for c in header_line.split('|')]
|
||||||
|
thead = '<thead><tr>' + ''.join(
|
||||||
|
f'<th{aligns[j] if j < len(aligns) else ""}>{header_cells[j]}</th>'
|
||||||
|
for j in range(len(header_cells))
|
||||||
|
) + '</tr></thead>'
|
||||||
|
|
||||||
|
# Collect body rows
|
||||||
|
tbody_rows = ''
|
||||||
|
while i < len(lines) and '|' in lines[i]:
|
||||||
|
row_line = lines[i].strip().strip('|')
|
||||||
|
row_cells = [c.strip() for c in row_line.split('|')]
|
||||||
|
tbody_rows += '<tr>' + ''.join(
|
||||||
|
f'<td{aligns[j] if j < len(aligns) else ""}>{row_cells[j]}</td>'
|
||||||
|
for j in range(len(row_cells))
|
||||||
|
) + '</tr>'
|
||||||
|
i += 1
|
||||||
|
|
||||||
|
result.append(f'<div class="table-wrap"><table>{thead}<tbody>{tbody_rows}</tbody></table></div>')
|
||||||
|
else:
|
||||||
|
result.append(lines[i])
|
||||||
|
i += 1
|
||||||
|
return '\n'.join(result)
|
||||||
|
|
||||||
|
def _process_block(self, text: str) -> str:
|
||||||
|
lines = text.split('\n')
|
||||||
|
output: List[str] = []
|
||||||
|
in_ul = False
|
||||||
|
in_ol = False
|
||||||
|
in_blockquote = False
|
||||||
|
i = 0
|
||||||
|
|
||||||
|
def close_lists():
|
||||||
|
nonlocal in_ul, in_ol, in_blockquote
|
||||||
|
if in_ul:
|
||||||
|
output.append('</ul>')
|
||||||
|
in_ul = False
|
||||||
|
if in_ol:
|
||||||
|
output.append('</ol>')
|
||||||
|
in_ol = False
|
||||||
|
if in_blockquote:
|
||||||
|
output.append('</blockquote>')
|
||||||
|
in_blockquote = False
|
||||||
|
|
||||||
|
while i < len(lines):
|
||||||
|
line = lines[i]
|
||||||
|
|
||||||
|
# Horizontal rule
|
||||||
|
if re.match(r'^(\*{3,}|-{3,}|_{3,})\s*$', line):
|
||||||
|
close_lists()
|
||||||
|
output.append('<hr>')
|
||||||
|
i += 1
|
||||||
|
continue
|
||||||
|
|
||||||
|
# ATX Headers
|
||||||
|
hm = re.match(r'^(#{1,6})\s+(.*)', line)
|
||||||
|
if hm:
|
||||||
|
close_lists()
|
||||||
|
level = len(hm.group(1))
|
||||||
|
content = hm.group(2).strip()
|
||||||
|
output.append(f'<h{level}>{content}</h{level}>')
|
||||||
|
i += 1
|
||||||
|
continue
|
||||||
|
|
||||||
|
# Blockquote
|
||||||
|
if line.startswith('> ') or line.startswith('>'):
|
||||||
|
if not in_blockquote:
|
||||||
|
close_lists()
|
||||||
|
output.append('<blockquote>')
|
||||||
|
in_blockquote = True
|
||||||
|
content = re.sub(r'^>\s?', '', line)
|
||||||
|
output.append(f'<p>{content}</p>')
|
||||||
|
i += 1
|
||||||
|
continue
|
||||||
|
elif in_blockquote:
|
||||||
|
output.append('</blockquote>')
|
||||||
|
in_blockquote = False
|
||||||
|
|
||||||
|
# Unordered list
|
||||||
|
ulm = re.match(r'^[\*\-\+]\s+(.*)', line)
|
||||||
|
if ulm:
|
||||||
|
if not in_ul:
|
||||||
|
close_lists()
|
||||||
|
output.append('<ul>')
|
||||||
|
in_ul = True
|
||||||
|
output.append(f'<li>{ulm.group(1)}</li>')
|
||||||
|
i += 1
|
||||||
|
continue
|
||||||
|
|
||||||
|
# Ordered list
|
||||||
|
olm = re.match(r'^\d+\.\s+(.*)', line)
|
||||||
|
if olm:
|
||||||
|
if not in_ol:
|
||||||
|
close_lists()
|
||||||
|
output.append('<ol>')
|
||||||
|
in_ol = True
|
||||||
|
output.append(f'<li>{olm.group(1)}</li>')
|
||||||
|
i += 1
|
||||||
|
continue
|
||||||
|
|
||||||
|
# Empty line — close lists, paragraph break
|
||||||
|
if not line.strip():
|
||||||
|
close_lists()
|
||||||
|
output.append('')
|
||||||
|
i += 1
|
||||||
|
continue
|
||||||
|
|
||||||
|
# Regular paragraph line
|
||||||
|
if in_ul or in_ol:
|
||||||
|
close_lists()
|
||||||
|
|
||||||
|
output.append(line)
|
||||||
|
i += 1
|
||||||
|
|
||||||
|
close_lists()
|
||||||
|
|
||||||
|
# Wrap consecutive non-tag lines in <p>
|
||||||
|
result = []
|
||||||
|
para: List[str] = []
|
||||||
|
|
||||||
|
def flush_para():
|
||||||
|
if para:
|
||||||
|
result.append('<p>' + '<br>'.join(para) + '</p>')
|
||||||
|
para.clear()
|
||||||
|
|
||||||
|
for line in output:
|
||||||
|
if not line:
|
||||||
|
flush_para()
|
||||||
|
elif line.startswith('<') and not line.startswith('<br'):
|
||||||
|
flush_para()
|
||||||
|
result.append(line)
|
||||||
|
else:
|
||||||
|
para.append(line)
|
||||||
|
flush_para()
|
||||||
|
|
||||||
|
return '\n'.join(result)
|
||||||
|
|
||||||
|
def _process_inline(self, text: str) -> str:
|
||||||
|
# Images before links
|
||||||
|
text = re.sub(r'!\[([^\]]*)\]\(([^)]+)\)',
|
||||||
|
lambda m: f'<img alt="{m.group(1)}" src="{_safe_url(m.group(2), image=True)}" loading="lazy">', text)
|
||||||
|
# Links
|
||||||
|
text = re.sub(r'\[([^\]]+)\]\(([^)]+)\)',
|
||||||
|
lambda m: f'<a href="{_safe_url(m.group(2))}" target="_blank" rel="noopener">{m.group(1)}</a>', text)
|
||||||
|
# Bold+italic
|
||||||
|
text = re.sub(r'\*\*\*(.+?)\*\*\*', r'<strong><em>\1</em></strong>', text)
|
||||||
|
text = re.sub(r'___(.+?)___', r'<strong><em>\1</em></strong>', text)
|
||||||
|
# Bold
|
||||||
|
text = re.sub(r'\*\*(.+?)\*\*', r'<strong>\1</strong>', text)
|
||||||
|
text = re.sub(r'__(.+?)__', r'<strong>\1</strong>', text)
|
||||||
|
# Italic
|
||||||
|
text = re.sub(r'\*([^\*\n]+?)\*', r'<em>\1</em>', text)
|
||||||
|
text = re.sub(r'_([^_\n]+?)_', r'<em>\1</em>', text)
|
||||||
|
# Strikethrough
|
||||||
|
text = re.sub(r'~~(.+?)~~', r'<del>\1</del>', text)
|
||||||
|
return text
|
||||||
175
declaude/site.py
Normal file
175
declaude/site.py
Normal file
|
|
@ -0,0 +1,175 @@
|
||||||
|
"""Builds the whole static site: assets, index, project and conversation pages."""
|
||||||
|
from __future__ import annotations
|
||||||
|
|
||||||
|
import json
|
||||||
|
from datetime import datetime, timezone
|
||||||
|
from pathlib import Path
|
||||||
|
from typing import Dict, Optional
|
||||||
|
|
||||||
|
from importlib.resources import files
|
||||||
|
|
||||||
|
from .html import HtmlBuilder
|
||||||
|
from .loader import DataLoader, MappingManager
|
||||||
|
from .markdown import MarkdownRenderer
|
||||||
|
|
||||||
|
CSS = files("declaude").joinpath("assets/style.css").read_text(encoding="utf-8")
|
||||||
|
JS = files("declaude").joinpath("assets/app.js").read_text(encoding="utf-8")
|
||||||
|
|
||||||
|
|
||||||
|
# ---------------------------------------------------------------------------
|
||||||
|
# SiteBuilder
|
||||||
|
# ---------------------------------------------------------------------------
|
||||||
|
|
||||||
|
class SiteBuilder:
|
||||||
|
"""Orchestrates generating the full static site."""
|
||||||
|
|
||||||
|
def __init__(self, output_dir: Path, loader: DataLoader, mapping: MappingManager):
|
||||||
|
self.out = output_dir
|
||||||
|
self.meta_file = output_dir / "_meta.json"
|
||||||
|
self.loader = loader
|
||||||
|
self.mapping = mapping
|
||||||
|
self.md = MarkdownRenderer()
|
||||||
|
self.builder = HtmlBuilder(self.md)
|
||||||
|
|
||||||
|
def _write(self, path: Path, content: str) -> None:
|
||||||
|
path.parent.mkdir(parents=True, exist_ok=True)
|
||||||
|
with open(path, "w", encoding="utf-8") as f:
|
||||||
|
f.write(content)
|
||||||
|
|
||||||
|
def build_assets(self) -> None:
|
||||||
|
assets = self.out / "assets"
|
||||||
|
assets.mkdir(parents=True, exist_ok=True)
|
||||||
|
(assets / "style.css").write_text(CSS, encoding="utf-8")
|
||||||
|
(assets / "app.js").write_text(JS, encoding="utf-8")
|
||||||
|
|
||||||
|
def build_all(self, new_uuids: Optional[set] = None) -> None:
|
||||||
|
new_uuids = new_uuids or set()
|
||||||
|
print(" Building assets...")
|
||||||
|
self.build_assets()
|
||||||
|
|
||||||
|
print(" Building index...")
|
||||||
|
meta = self._load_meta()
|
||||||
|
html = self.builder.build_index(self.loader, self.mapping, meta, new_uuids)
|
||||||
|
self._write(self.out / "index.html", html)
|
||||||
|
|
||||||
|
print(" Building all_conversations...")
|
||||||
|
html = self.builder.build_all_conversations(self.loader, self.mapping, new_uuids)
|
||||||
|
self._write(self.out / "all_conversations.html", html)
|
||||||
|
|
||||||
|
print(f" Building {len(self.loader.projects)} project pages...")
|
||||||
|
for proj in self.loader.projects.values():
|
||||||
|
pid = proj.get("uuid","")
|
||||||
|
html = self.builder.build_project_page(proj, self.loader, self.mapping)
|
||||||
|
self._write(self.out / "projects" / pid / "index.html", html)
|
||||||
|
|
||||||
|
print(f" Building {len(self.loader.conversations)} conversation pages...")
|
||||||
|
for i, conv in enumerate(self.loader.conversations, 1):
|
||||||
|
cid = conv.get("uuid","")
|
||||||
|
html = self.builder.build_conversation_page(conv, self.loader, self.mapping)
|
||||||
|
self._write(self.out / "conversations" / f"{cid}.html", html)
|
||||||
|
if i % 100 == 0:
|
||||||
|
print(f" {i}/{len(self.loader.conversations)}")
|
||||||
|
|
||||||
|
self._save_meta()
|
||||||
|
print(f" Done. Archive at: {self.out / 'index.html'}")
|
||||||
|
|
||||||
|
def build_remap(self) -> None:
|
||||||
|
"""Regenerate only index, all_conversations, and project pages (fast after mapping change)."""
|
||||||
|
print(" Rebuilding index and project pages...")
|
||||||
|
meta = self._load_meta()
|
||||||
|
new_uuids: set = set()
|
||||||
|
|
||||||
|
html = self.builder.build_index(self.loader, self.mapping, meta, new_uuids)
|
||||||
|
self._write(self.out / "index.html", html)
|
||||||
|
|
||||||
|
html = self.builder.build_all_conversations(self.loader, self.mapping, new_uuids)
|
||||||
|
self._write(self.out / "all_conversations.html", html)
|
||||||
|
|
||||||
|
for proj in self.loader.projects.values():
|
||||||
|
pid = proj.get("uuid","")
|
||||||
|
html = self.builder.build_project_page(proj, self.loader, self.mapping)
|
||||||
|
self._write(self.out / "projects" / pid / "index.html", html)
|
||||||
|
|
||||||
|
print(" Remap complete.")
|
||||||
|
|
||||||
|
def build_update(self, new_loader: DataLoader) -> None:
|
||||||
|
"""Merge new backup data, regenerate changed pages only."""
|
||||||
|
existing_uuids = {c.get("uuid","") for c in self.loader.conversations}
|
||||||
|
new_uuids = set()
|
||||||
|
changed_uuids = set()
|
||||||
|
|
||||||
|
for conv in new_loader.conversations:
|
||||||
|
cid = conv.get("uuid","")
|
||||||
|
if cid not in existing_uuids:
|
||||||
|
new_uuids.add(cid)
|
||||||
|
else:
|
||||||
|
# Find old version and compare updated_at
|
||||||
|
old = next((c for c in self.loader.conversations if c.get("uuid") == cid), None)
|
||||||
|
if old and old.get("updated_at","") != conv.get("updated_at",""):
|
||||||
|
changed_uuids.add(cid)
|
||||||
|
|
||||||
|
print(f" New conversations: {len(new_uuids)}, Changed: {len(changed_uuids)}")
|
||||||
|
|
||||||
|
# Replace loader data with new
|
||||||
|
self.loader.conversations = new_loader.conversations
|
||||||
|
self.loader.projects = new_loader.projects
|
||||||
|
self.loader.user = new_loader.user
|
||||||
|
|
||||||
|
# Regenerate only new/changed conversation pages
|
||||||
|
conv_map = {c.get("uuid",""): c for c in self.loader.conversations}
|
||||||
|
to_regen = new_uuids | changed_uuids
|
||||||
|
for cid in to_regen:
|
||||||
|
if cid in conv_map:
|
||||||
|
conv = conv_map[cid]
|
||||||
|
html = self.builder.build_conversation_page(conv, self.loader, self.mapping)
|
||||||
|
self._write(self.out / "conversations" / f"{cid}.html", html)
|
||||||
|
|
||||||
|
# Rebuild index pages
|
||||||
|
meta = self._load_meta()
|
||||||
|
html = self.builder.build_index(self.loader, self.mapping, meta, new_uuids)
|
||||||
|
self._write(self.out / "index.html", html)
|
||||||
|
|
||||||
|
html = self.builder.build_all_conversations(self.loader, self.mapping, new_uuids)
|
||||||
|
self._write(self.out / "all_conversations.html", html)
|
||||||
|
|
||||||
|
# Rebuild affected project pages
|
||||||
|
affected_projects: set = set()
|
||||||
|
for cid in to_regen:
|
||||||
|
pid = self.mapping.get_project(cid)
|
||||||
|
if pid:
|
||||||
|
affected_projects.add(pid)
|
||||||
|
for pid in affected_projects:
|
||||||
|
if pid in self.loader.projects:
|
||||||
|
proj = self.loader.projects[pid]
|
||||||
|
html = self.builder.build_project_page(proj, self.loader, self.mapping)
|
||||||
|
self._write(self.out / "projects" / pid / "index.html", html)
|
||||||
|
|
||||||
|
# Rebuild all project pages (new projects may have appeared)
|
||||||
|
for proj in self.loader.projects.values():
|
||||||
|
pid = proj.get("uuid","")
|
||||||
|
if pid not in affected_projects:
|
||||||
|
html = self.builder.build_project_page(proj, self.loader, self.mapping)
|
||||||
|
self._write(self.out / "projects" / pid / "index.html", html)
|
||||||
|
|
||||||
|
self.build_assets()
|
||||||
|
self._save_meta()
|
||||||
|
print(f" Update complete. {len(new_uuids)} new, {len(changed_uuids)} changed.")
|
||||||
|
|
||||||
|
def _load_meta(self) -> Dict:
|
||||||
|
if self.meta_file.exists():
|
||||||
|
try:
|
||||||
|
with open(self.meta_file, encoding="utf-8") as f:
|
||||||
|
return json.load(f)
|
||||||
|
except Exception:
|
||||||
|
pass
|
||||||
|
return {}
|
||||||
|
|
||||||
|
def _save_meta(self) -> None:
|
||||||
|
meta = {
|
||||||
|
"generated_at": datetime.now(timezone.utc).isoformat(),
|
||||||
|
"conversation_uuids": [c.get("uuid","") for c in self.loader.conversations],
|
||||||
|
"project_uuids": list(self.loader.projects.keys()),
|
||||||
|
}
|
||||||
|
self.meta_file.parent.mkdir(parents=True, exist_ok=True)
|
||||||
|
with open(self.meta_file, "w", encoding="utf-8") as f:
|
||||||
|
json.dump(meta, f, ensure_ascii=False, indent=2)
|
||||||
BIN
docs/screenshots/conversation.png
Normal file
BIN
docs/screenshots/conversation.png
Normal file

Binary file not shown.
|
After Width: | Height: | Size: 80 KiB |
BIN
docs/screenshots/index.png
Normal file
BIN
docs/screenshots/index.png
Normal file

Binary file not shown.
|
After Width: | Height: | Size: 90 KiB |
BIN
docs/screenshots/project.png
Normal file
BIN
docs/screenshots/project.png
Normal file

Binary file not shown.
|
After Width: | Height: | Size: 84 KiB |
|
|
@ -1 +0,0 @@
|
||||||
{}
|
|
||||||
52
pyproject.toml
Normal file
52
pyproject.toml
Normal file
|
|
@ -0,0 +1,52 @@
|
||||||
|
[build-system]
|
||||||
|
requires = ["hatchling>=1.24"]
|
||||||
|
build-backend = "hatchling.build"
|
||||||
|
|
||||||
|
[project]
|
||||||
|
name = "claude-export-html"
|
||||||
|
dynamic = ["version"]
|
||||||
|
description = "Convert a Claude.ai data export into a browsable static HTML archive"
|
||||||
|
readme = "README.en.md"
|
||||||
|
license = "MIT"
|
||||||
|
license-files = ["LICENSE"]
|
||||||
|
authors = [{ name = "Egor Deev", email = "egor@deev.space" }]
|
||||||
|
requires-python = ">=3.9"
|
||||||
|
dependencies = []
|
||||||
|
keywords = ["claude", "anthropic", "export", "archive", "html", "backup"]
|
||||||
|
classifiers = [
|
||||||
|
"Programming Language :: Python :: 3",
|
||||||
|
"Operating System :: OS Independent",
|
||||||
|
"Environment :: Console",
|
||||||
|
"Topic :: Utilities",
|
||||||
|
]
|
||||||
|
|
||||||
|
[project.urls]
|
||||||
|
Homepage = "https://github.com/EDeev/declaude"
|
||||||
|
Issues = "https://github.com/EDeev/declaude/issues"
|
||||||
|
Demo = "https://fe0.ru/declaude/"
|
||||||
|
|
||||||
|
[project.scripts]
|
||||||
|
declaude = "declaude.cli:main"
|
||||||
|
|
||||||
|
[tool.hatch.version]
|
||||||
|
path = "declaude/__init__.py"
|
||||||
|
|
||||||
|
[tool.hatch.build.targets.wheel]
|
||||||
|
packages = ["declaude"]
|
||||||
|
|
||||||
|
[tool.hatch.build.targets.sdist]
|
||||||
|
include = ["declaude", "tests", "README.md", "README.en.md", "LICENSE"]
|
||||||
|
|
||||||
|
[tool.ruff]
|
||||||
|
target-version = "py39"
|
||||||
|
line-length = 120
|
||||||
|
|
||||||
|
[tool.ruff.lint]
|
||||||
|
select = ["E", "F", "W", "B", "S"]
|
||||||
|
ignore = ["E501", "S110"]
|
||||||
|
|
||||||
|
[tool.ruff.lint.per-file-ignores]
|
||||||
|
"tests/*" = ["S101"]
|
||||||
|
|
||||||
|
[tool.pytest.ini_options]
|
||||||
|
testpaths = ["tests"]
|
||||||
3
requirements-dev.txt
Normal file
3
requirements-dev.txt
Normal file
|
|
@ -0,0 +1,3 @@
|
||||||
|
pytest==8.4.2
|
||||||
|
ruff==0.14.0
|
||||||
|
build==1.3.0
|
||||||
0
tests/__init__.py
Normal file
0
tests/__init__.py
Normal file
13
tests/fixtures/backup/conversations.json
vendored
Normal file
13
tests/fixtures/backup/conversations.json
vendored
Normal file
|
|
@ -0,0 +1,13 @@
|
||||||
|
[
|
||||||
|
{"uuid": "c-1", "name": "Нормализация до 3НФ", "created_at": "2026-02-03T09:00:00Z", "updated_at": "2026-02-03T09:30:00Z",
|
||||||
|
"chat_messages": [
|
||||||
|
{"uuid": "m-1", "sender": "human", "text": "Как привести таблицу к 3НФ?", "created_at": "2026-02-03T09:00:00Z", "content": [{"type": "text", "text": "Как привести таблицу к 3НФ?"}], "attachments": [], "files": []},
|
||||||
|
{"uuid": "m-2", "sender": "assistant", "text": "", "created_at": "2026-02-03T09:01:00Z", "content": [{"type": "text", "text": "## Шаги\n\n1. Убрать **повторяющиеся группы**\n2. Вынести *частичные* зависимости\n\n| Форма | Условие |\n|---|---|\n| 1НФ | атомарность |\n| 2НФ | нет частичных |\n\n```sql\nSELECT id, name FROM users WHERE id > 10;\n```\n\nСм. [документацию](https://www.postgresql.org/docs/) и `inline code`.\n\nОпасная ссылка: [клик](javascript:alert(1)) и картинка \n\n<script>alert(3)</script>"}], "attachments": [], "files": []}
|
||||||
|
]},
|
||||||
|
{"uuid": "c-2", "name": "", "created_at": "2026-02-10T12:00:00Z", "updated_at": "2026-02-10T12:05:00Z",
|
||||||
|
"chat_messages": [
|
||||||
|
{"uuid": "m-3", "sender": "human", "text": "Напиши функцию на Python", "created_at": "2026-02-10T12:00:00Z", "content": [{"type": "text", "text": "Напиши функцию на Python"}], "attachments": [], "files": []},
|
||||||
|
{"uuid": "m-4", "sender": "assistant", "text": "", "created_at": "2026-02-10T12:01:00Z", "content": [{"type": "text", "text": "```python\ndef add(a, b):\n return a + b\n```"}], "attachments": [], "files": []}
|
||||||
|
]},
|
||||||
|
{"uuid": "c-3", "name": "Пустой чат", "created_at": "2026-02-11T12:00:00Z", "updated_at": "2026-02-11T12:00:00Z", "chat_messages": []}
|
||||||
|
]
|
||||||
1
tests/fixtures/backup/projects/p-1.json
vendored
Normal file
1
tests/fixtures/backup/projects/p-1.json
vendored
Normal file
|
|
@ -0,0 +1 @@
|
||||||
|
{"uuid": "p-1", "name": "Курсовая по базам данных", "description": "Проектирование схемы и запросы", "created_at": "2026-02-01T10:00:00Z", "updated_at": "2026-03-01T10:00:00Z", "prompt_template": "Отвечай кратко", "docs": [{"filename": "schema.sql", "content": "CREATE TABLE users (id int);", "created_at": "2026-02-02T10:00:00Z"}]}
|
||||||
1
tests/fixtures/backup/users.json
vendored
Normal file
1
tests/fixtures/backup/users.json
vendored
Normal file
|
|
@ -0,0 +1 @@
|
||||||
|
[{"uuid": "u-1", "full_name": "Тестовый Пользователь", "email_address": "user@example.com"}]
|
||||||
1
tests/fixtures/mapping.json
vendored
Normal file
1
tests/fixtures/mapping.json
vendored
Normal file
|
|
@ -0,0 +1 @@
|
||||||
|
{"c-1": "p-1"}
|
||||||
55
tests/test_build.py
Normal file
55
tests/test_build.py
Normal file
|
|
@ -0,0 +1,55 @@
|
||||||
|
import json
|
||||||
|
import shutil
|
||||||
|
from pathlib import Path
|
||||||
|
|
||||||
|
import pytest
|
||||||
|
|
||||||
|
from declaude import DataLoader, MappingManager, SiteBuilder
|
||||||
|
from declaude.cli import main
|
||||||
|
|
||||||
|
FIXTURE = Path(__file__).parent / "fixtures" / "backup"
|
||||||
|
|
||||||
|
|
||||||
|
@pytest.fixture
|
||||||
|
def archive(tmp_path):
|
||||||
|
loader = DataLoader(FIXTURE)
|
||||||
|
loader.load()
|
||||||
|
mapping = MappingManager(tmp_path / "mapping.json")
|
||||||
|
mapping.load()
|
||||||
|
mapping.assign("c-1", "p-1")
|
||||||
|
SiteBuilder(tmp_path / "out", loader, mapping).build_all()
|
||||||
|
return tmp_path / "out"
|
||||||
|
|
||||||
|
|
||||||
|
def test_full_build_creates_all_pages(archive):
|
||||||
|
for rel in ("index.html", "all_conversations.html", "projects/p-1/index.html",
|
||||||
|
"conversations/c-1.html", "conversations/c-2.html", "conversations/c-3.html",
|
||||||
|
"assets/style.css", "assets/app.js"):
|
||||||
|
assert (archive / rel).is_file(), rel
|
||||||
|
|
||||||
|
|
||||||
|
def test_conversation_page_content(archive):
|
||||||
|
page = (archive / "conversations" / "c-1.html").read_text(encoding="utf-8")
|
||||||
|
assert "Нормализация до 3НФ" in page
|
||||||
|
assert "<table" in page
|
||||||
|
assert 'href="https://www.postgresql.org/docs/"' in page
|
||||||
|
assert "javascript:" not in page
|
||||||
|
assert "<script>alert" not in page
|
||||||
|
|
||||||
|
|
||||||
|
def test_project_page_lists_assigned_conversation(archive):
|
||||||
|
page = (archive / "projects" / "p-1" / "index.html").read_text(encoding="utf-8")
|
||||||
|
assert "Курсовая по базам данных" in page
|
||||||
|
assert "c-1.html" in page and "c-2.html" not in page
|
||||||
|
|
||||||
|
|
||||||
|
def test_cli_build_and_map(tmp_path, monkeypatch):
|
||||||
|
src = tmp_path / "backup"
|
||||||
|
shutil.copytree(FIXTURE, src)
|
||||||
|
out, mp = tmp_path / "out", tmp_path / "mapping.json"
|
||||||
|
monkeypatch.setattr("sys.argv", ["declaude", "--build", "--source", str(src), "--output", str(out), "--mapping", str(mp)])
|
||||||
|
main()
|
||||||
|
assert (out / "index.html").is_file()
|
||||||
|
monkeypatch.setattr("sys.argv", ["declaude", "--map", "c-2", "p-1", "--source", str(src), "--output", str(out), "--mapping", str(mp)])
|
||||||
|
main()
|
||||||
|
assert json.loads(mp.read_text(encoding="utf-8")).get("c-2") == "p-1"
|
||||||
54
tests/test_markdown.py
Normal file
54
tests/test_markdown.py
Normal file
|
|
@ -0,0 +1,54 @@
|
||||||
|
import pytest
|
||||||
|
|
||||||
|
from declaude import MarkdownRenderer
|
||||||
|
|
||||||
|
md = MarkdownRenderer()
|
||||||
|
|
||||||
|
|
||||||
|
@pytest.mark.parametrize("url", [
|
||||||
|
"javascript:alert(1)",
|
||||||
|
"JaVaScRiPt:alert(1)",
|
||||||
|
" javascript:alert(1)",
|
||||||
|
"java\tscript:alert(1)",
|
||||||
|
"data:text/html;base64,PHNjcmlwdD4=",
|
||||||
|
"vbscript:msgbox",
|
||||||
|
])
|
||||||
|
def test_dangerous_link_schemes_are_neutralized(url):
|
||||||
|
html = md.render(f"[клик]({url})")
|
||||||
|
assert 'href="#"' in html
|
||||||
|
assert "script:" not in html.lower().replace("#", "")
|
||||||
|
|
||||||
|
|
||||||
|
@pytest.mark.parametrize("url", ["https://example.com/a?b=1", "http://example.com", "mailto:me@example.com", "#anchor", "/local/page"])
|
||||||
|
def test_normal_links_are_kept(url):
|
||||||
|
assert f'href="{url}"'.replace("&", "&") in md.render(f"[ссылка]({url})")
|
||||||
|
|
||||||
|
|
||||||
|
def test_image_rejects_javascript_and_svg_data():
|
||||||
|
assert 'src="#"' in md.render("")
|
||||||
|
assert 'src="#"' in md.render("")
|
||||||
|
assert 'src="https://example.com/a.png"' in md.render("")
|
||||||
|
|
||||||
|
|
||||||
|
def test_raw_html_is_escaped():
|
||||||
|
html = md.render("<script>alert(3)</script>")
|
||||||
|
assert "<script>" not in html
|
||||||
|
assert "<script>" in html
|
||||||
|
|
||||||
|
|
||||||
|
def test_code_block_is_escaped_and_highlighted():
|
||||||
|
html = md.render("```python\nif a < b:\n return '<x>'\n```")
|
||||||
|
assert "<pre" in html and "<x>" in html
|
||||||
|
assert "<x>" not in html
|
||||||
|
|
||||||
|
|
||||||
|
def test_table_and_emphasis():
|
||||||
|
html = md.render("| A | B |\n|---|---|\n| **1** | *2* |")
|
||||||
|
assert "<table" in html
|
||||||
|
assert "<strong>1</strong>" in html and "<em>2</em>" in html
|
||||||
|
|
||||||
|
|
||||||
|
def test_headings_and_lists():
|
||||||
|
html = md.render("## Заголовок\n\n1. один\n2. два")
|
||||||
|
assert "<h2" in html and "Заголовок" in html
|
||||||
|
assert "<ol" in html and html.count("<li") == 2
|
||||||
Loading…
Add table
Reference in a new issue